Модели open source ИИ в 2026 году: цифры по загрузкам, использованию и внедрению
Ключевые выводы
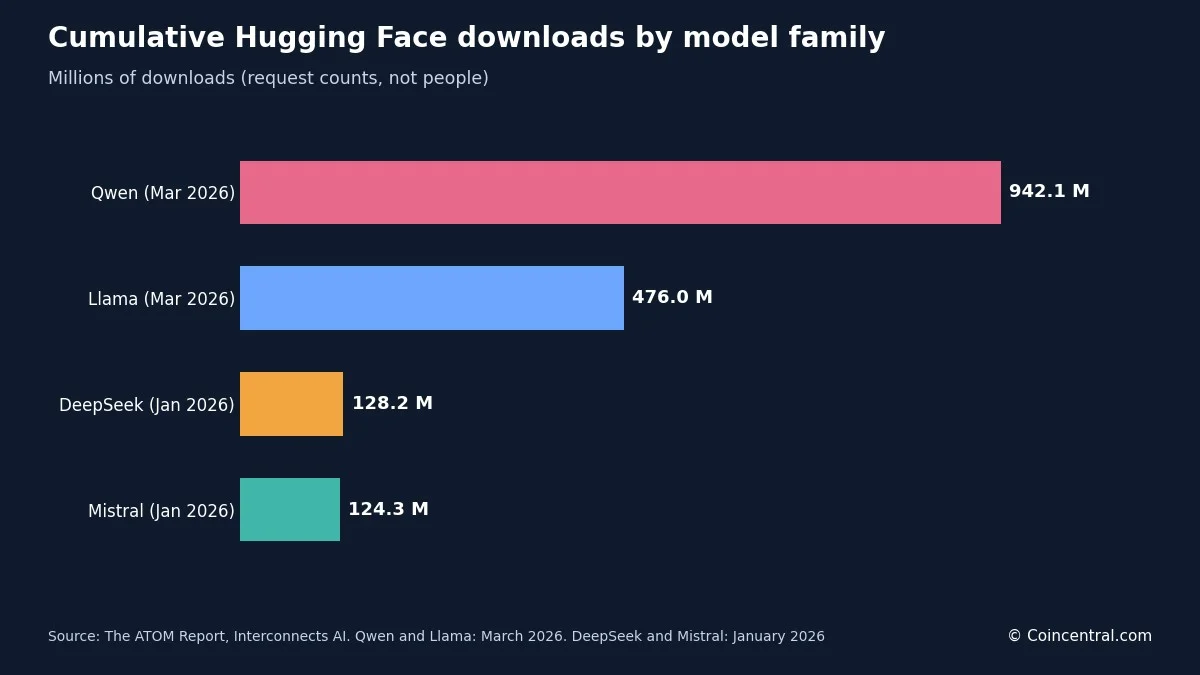
- •Qwen от Alibaba достигла 942,1 млн совокупных загрузок на Hugging Face к марту 2026 года — примерно вдвое больше 476,0 млн у Llama от Meta.
- •По оценке Mozilla, открытые модели обрабатывают около 33% активного использования ИИ, но получают лишь около 4% мировых доходов ИИ.
- •Открытые модели Китая обошли США по совокупным загрузкам в конце июля 2025 года и лидировали с отрывом в 428 млн по состоянию на март 2026 года.
- •Лишь 51% команд, работающих с открытыми моделями, доводят проекты до продакшна против 63% у закрытых моделей; разрыв объясняется главным образом нехваткой инфраструктуры, а не качеством моделей.
- •Затраты на инференс моделей класса GPT-4 снизились примерно в 50 раз за 36 месяцев — с около $20 до $0,40 за миллион токенов, что отчёт связывает с конкуренцией открытых весов.
Модели open source ИИ стали рутинными компонентами разработки ПО. Разработчики скачивают их, строят на их основе приложения и запускают на собственном оборудовании. Несколько организаций пытаются измерить эту активность, и их цифры не всегда совпадают. В этом отчёте основные показатели представлены бок о бок: загрузки, использование токенов, региональные сдвиги, затраты, опросы разработчиков и финансирование компаний. Каждый показатель сопровождается источником, датой и указанием на то, что именно он измеряет.
К каждой метрике ниже относится одна оговорка. Загрузка — это запрос файла, а не человек. Подсчёт токенов измеряет выполненную работу, а не количество копий. Большинство открытых моделей точнее называть open-weight моделями: обученные параметры открыты, но обучающие данные и код часто закрыты. Поэтому цифры описывают разные уровни внедрения: дистрибуцию, инференс, эксперименты и продакшн-развёртывание. Их следует читать вместе, а не воспринимать как взаимозаменяемые меры рыночной доли.
Ключевые показатели вкратце:
- К марту 2026 года Qwen достигла 942,1 млн совокупных загрузок на Hugging Face; Llama — 476,0 млн.
- DeepSeek обработала 14,37 трлн токенов на OpenRouter с ноября 2024 года по ноябрь 2025 года.
- Открытые модели обрабатывают около 33% активного использования ИИ, но приносят около 4% доходов ИИ, по данным Mozilla.
- 79% разработчиков, добавляющих функции ИИ, используют открытые модели, против 71% для закрытых.
- Команды, работающие с открытыми моделями, реже доводят проекты до продакшна: 51% против 63% у закрытых моделей.
Статистика загрузок open source ИИ по семействам моделей
Отчёт ATOM отслеживает около 1 500 открытых языковых моделей на Hugging Face и определяет загрузку как любой HTTP-запрос к эндпоинту файла модели, включая автоматические загрузки инструментами вроде transformers или curl.
Семейство Qwen от Alibaba накопило 942,1 млн загрузок к марту 2026 года, а семейство Llama от Meta достигло 476,0 млн в том же месяце. Qwen впервые обошла Llama в сентябре 2025 года, когда показатели составляли 325,4 млн и 323,7 млн. Шесть месяцев спустя разрыв вырос до 466,1 млн: за этот период Qwen добавила около 617 млн загрузок, тогда как Llama — около 152 млн.
Источник: The ATOM Report,connects AI, совокупные загрузки на Hugging Face.
DeepSeek и Mistral значительно отстают от лидеров. DeepSeek обошла Mistral в январе 2026 года с 128,2 млн загрузок против 124,3 млн. Ранее лидировала Mistral — её доля среди новых производных моделей достигла пика в 57% в декабре 2023 года благодаря Mistral 7B и Mixtral. Доля производных Meta достигла пика в 44% в августе 2024 года и снизилась до 11% к февралю 2026 года.
Новые американские лаборатории стартуют с гораздо меньшей базы. Nemotron от NVIDIA зафиксировал 30,7 млн загрузок с августа 2025 года по март 2026 года, OLMo от Allen Institute for AI — 14,8 млн, а Granite от IBM — 8,6 млн.
Корпоративные заявления следуют иным правилам. Meta сообщила, что Llama превысила 1 млрд загрузок 18 марта 2025 года. Google заявила, что Gemma превысила 1 млрд 20 августа 2026 года, а инженер Google отметил, что этот подсчёт не включает интеграции в Android и Chrome. Ни одна из корпоративных цифр не прошла независимый аудит, а подсчёт ATOM для Llama охватывает только отслеживаемые модели генерации текста на Hugging Face, поэтому эти наборы чисел нельзя сравнивать напрямую.
Лидерство Qwen обеспечивает её месячный объём. В феврале 2026 года одна Qwen сгенерировала 153,6 млн загрузок, тогда как следующие восемь организаций с открытыми моделями в сумме — 71,2 млн.
Статистика загрузок open source ИИ по регионам
ATOM относит каждую модель к США, Китаю или Европе по месту размещения штаб-квартиры выпустившей организации. Общее число отслеживаемых загрузок достигло 2,04 млрд к марту 2026 года против 339 млн годом ранее.
Источник: The ATOM Report, Interconnects AI, совокупные загрузки на Hugging Face.
Ни один регион не сократился. В марте 2025 года США опережали Китай на 80 млн загрузок; к марту 2026 года Китай опережал на 428 млн, при этом ATOM относит переломный момент к концу июля 2025 года.
Данные опросов указывают в ту же сторону. Опрос разработчиков Mozilla выявил использование открытых моделей на уровне 89% в Большом Китае и Восточной Азии — самый высокий показатель среди регионов, при этом в Западной Европе он составил 70%. Трафик OpenRouter демонстрирует аналогичный сдвиг: анализ Mozilla показал рост китайских open-weight моделей с менее чем 2% недельного трафика в конце 2024 года до 45% к апрелю 2026 года.
Летний отчёт Hugging Face за 2026 год изучил размер моделей. Почти в каждом месяце 2026 года крупнейшая открытая модель китайской лаборатории превосходила любую модель американской лаборатории. Месячный потолок Китая составлял от 754 млрд до 2,78 трлн параметров, тогда как модели США оставались ниже 130 млрд параметров в пяти из семи месяцев. AMD и NVIDIA выпустили более 200 новых репозиториев моделей каждая в 2026 году — больше любой другой организации, — а LiquidAI заняла третье место с примерно 100.
Статистика использования токенов открытыми моделями
Загрузки измеряют, как часто копируются веса; токены измеряют, сколько работы выполняет модель. OpenRouter и a16z проанализировали более 100 трлн токенов реального платформенного трафика с ноября 2024 года по ноябрь 2025 года. DeepSeek обработала 14,37 трлн токенов, опережая Qwen с 5,59 трлн и Meta Llama с 3,96 трлн — иная картина, чем в рейтинге загрузок, где Qwen с отрывом лидирует.
Источник: OpenRouter и a16z, State of AI, токены, маршрутизированные через OpenRouter, ноябрь 2024 — ноябрь 2025.
К концу 2025 года open-weight модели составляли примерно треть использования OpenRouter. За годовой период китайские открытые модели в среднем занимали 13,0% недельного объёма токенов, открытые модели остального мира — 13,7%, а проприетарные модели остального мира — 70%.
Собственная серия данных ATOM по OpenRouter показывает, насколько быстро могут меняться доли. DeepSeek V3 и R1 вместе составляли до 75,6% токенов инференса открытых моделей в июне 2025 года, упав до 31,1% к январю 2026 года. Доля Meta снизилась с пика 37,4% в январе 2025 года до нуля к августу 2025 года. Лидерство по этому показателю может меняться за считанные месяцы.
Presenc AI, используя иную комбинацию источников, сообщает меньшую долю открытых моделей: около 15% токенов инференса в январе 2026 года против около 1% годом ранее. В этой оценке DeepSeek удерживает около 6%, Qwen — около 5%, Llama — около 3%.
Open source против закрытого ИИ: использование, доходы и производительность
Mozilla опубликовала свой первый отчёт State of Open Source AI в июле 2026 года. В нём отмечается, что открытые модели обрабатывают около 33% активного использования ИИ, но получают около 4% мировых доходов ИИ; закрытые модели accounted за оставшиеся 67% использования и 96% доходов. Расхождение объясняется тем, как открытые модели зарабатывают: никто не платит лицензионную плату за токен за запуск открытых весов, поэтому доходы достаются тому, кто размещает модель, — часто это инфраструктура самого покупателя.
Другие источники сообщают меньшую долю использования. MIT Sloan, как цитирует TechnologyChecker, оценивает закрытые модели примерно в 80% использования моделей и указывает, что открытые модели достигают около 90% производительности закрытых на момент выпуска.
Разрыв в производительности со временем менялся. Данные Mozilla по Chatbot Arena показывают снижение среднего разрыва с примерно 8,04% до 0,5% к августу 2024 года. Затем он снова вырос после выпуска закрытыми лабораториями новых reasoning-моделей и составил 3,3 процентных пункта в марте 2026 года.
BenchLM использует другую шкалу. По состоянию на 20 октября 2026 года 12 из топ-50 моделей (24%) были open-weight, как и 494 из 972 отслеживаемых моделей (51%). Лучшая открытая модель, MiMo-V2.6-Pro от Xiaomi, набрала 73,66 из 100 и заняла 12-е место — на 13,03 балла позади лучшей проприетарной модели, Claude Opus 5.5. BenchLM указывает разрыв Arena Elo между лучшей закрытой и лучшей открытой моделью в 36,8 балла на 15 октября 2026 года против 29,2 балла примерно годом ранее. На странице это названо сокращением разрыва, но напечатанные цифры показывают его увеличение, поэтому тренд следует читать с осторожностью.
Разрыв также зависит от задачи. Сравнение Presenc AI за май 2026 года показывает почти паритет в тестах на знания и программирование и значительное преимущество закрытых моделей в сложных тестах на рассуждение.
Источник: Presenc AI, Open Source vs Closed AI Market Share 2026. Значения приблизительные.
Одиночные результаты могут ломать картину. GLM-5.2 от Z.ai набрала 81,0 на Terminal-Bench 2.1 против 83,4 у GPT-5.5, а на SWE-bench Pro — 62,1 против 58,6 у GPT-5.5. В собственном наборе данных Mozilla лучшая открытая модель показала 67,9 на Terminal-Bench2.1 до выхода GLM-5.2 — данные отчёта уже устарели к дате публикации.
Статистика внедрения разработчиками и продакшн-использования
Отчёт Mozilla опирается на опрос SlashData среди 1 494 разработчиков, проведённый в мае 2026 года, среди разработчиков, добавляющих функции ИИ в приложения.
Источник: опрос разработчиков Mozilla и SlashData 2026, май 2026. Первые две строки пересекаются.
Различия проявляются на этапе продакшна. Среди команд, работающих с открытыми моделями, до продакшна доходят 51%, против 63% для закрытых моделей. На странице отчёта Mozilla указана цифра 53% для открытых моделей, а в блоге — 51%. Alvaro Ruiz Cubero из SlashData объясняет разрыв нехваткой инфраструктуры, а не качеством моделей.
На вопрос, что мешает проектам с открытыми моделями, разработчики чаще всего называли стоимость инфраструктуры — 27%, далее следуют безопасность и соответствие требованиям — 26%, сопровождение и обновления — 24% и сложность развёртывания — 23%. Четыре ответа близки по весу, поэтому одно решение проблему не устранит.
Использование зависит от задачи. Presenc AI оценивает, что около 94% работы на периферии и на устройствах использует открытую модель, около 85% — для чувствительных к стоимости высокообъёмных задач и около 71% — для работы с конфиденциальными данными в таких областях, как право, финансы и здравоохранение.
Источник: Presenc AI, Open Source vs Closed AI Market Share 2026.
Результаты опросов зависят от формулировки вопроса. Presenc AI утверждает, что около 89% предприятий используют хотя бы одну open-source модель в продакшне, тогда как Linux Foundation, как цитирует TechnologyChecker, установила, что 63% организаций используют open-source ИИ, а 89% используют какой-либо open source в своём ИИ-стеке.
Видимое развёртывание в вебе значительно ниже. TechnologyChecker просканировал более 50 млн доменов в мае 2026 года и обнаружил, что Botpress — самый распространённый открытый ИИ-фреймворк, который удалось выявить, — работает на 1 558 доменах против 52 682 у закрытого OpenAI API и 1 349 у Dialogflow от Google. Из 899 компаний, связанных с развёртыванием Botpress, 64% имели не более 10 сотрудников, 81% — менее 50, а около 5% — 1 000 и более. На США пришлось около 23% выявленных развёртываний, далее следуют Испания с 6,9% и Индия с 6%. TechnologyChecker отмечает, что его метод не видит бэкенд-инструменты вроде transformers, LangChain или Ollama; подсчёты отражают только видимый для браузера уровень.
Статистика экосистемы Hugging Face
Весенний отчёт Hugging Face за 2026 год сообщил, что в 2025 году платформа выросла до 13 млн пользователей, более 2 млн публичных моделей и свыше 500 000 публичных датасетов. Летний отчёт, охватывающий январь–август 2026 года, зафиксировал рост публичных репозиториев моделей с 2,43 млн до 2,96 млн, датасетов — с 711 000 до 1 млн, а Spaces — с 1,00 млн до 1,44 млн.
Внимание сильно сконцентрировано. Весенний отчёт показал, что около половины всех моделей имеют менее 200 суммарных загрузок, а топ-200 моделей — 0,01% от общего числа — удерживают 49,6% всех загрузок. Летний отчёт оценил долю моделей с менее чем 200 загрузками за всю историю в 85,6% и указал, что 1,5% репозиториев account за 99,2% загрузок. Два отчёта считают по-разному и охватывают разные периоды, но оба показывают одну и ту же картину: небольшая группа моделей собирает почти весь трафик.
Stanford AI Index 2026 насчитывает около 5,6 млн проектов, связанных с ИИ, на GitHub и Hugging Face, из которых лишь 206 8803,7%) имеют 10 и более звёзд. Загрузки моделей на Hugging Face более чем утроились между 2023 и 2025 годами, достигнув 332 000 за один квартал.
Источник: Hugging Face, State of Open Source on Hugging Face: Spring 2026, опубликовано 17 марта 2026 года.
Среднее росло значительно быстрее медианы. Hugging Face объясняет это квантизацией и архитектурами mixture-of-experts, подтянувшими верхний сегмент, тогда как использование малых моделей остаётся на прежнем уровне. Малые модели по-прежнему получают большинство загрузок: модели с менее чем 1 млрд параметров составляют 83% загрузок за всё время, а модели свыше 100 млрд — 1%; при этом в 2026 году 3% загрузок пришлось на модели свыше 70 млрд параметров.
Лайки и загрузки измеряют разные вещи. Топ-25 репозиториев по загрузкам 2026 года и топ-25 по лайкам имеют ровно одну общую позицию. Модель all-MiniLM-L6-v2 была загружена 1,55 млрд раз за семь месяцев и имеет 5 156 лайков.
Qwen стала базой, на которой строят другие. Модели на основе Qwen насчитывают 151 448 производных на Hub — в 2,6 раза больше, чем у Meta, и в 4,7 раза больше, чем одни лишь репозитории Llama, — далее следует Google с 82 506. Производные Qwen росли примерно на 180–210 новых репозиториев в день в первые семь месяцев 2026 года.
Локальный запуск следует той же схеме. Qwen фиксирует 39,6 млн загрузок GGUF в месяц против 20,8 млн у Gemma и 7,5 млн у Llama. GGUF — это формат файла, используемый локальными раннерами вроде llama.cpp.
Самый быстрый рост приходится на слой рантаймов. Репозитории, использующие библиотеку gguf, выросли на 464%, lerobot — на 194%, а mlx от Apple — на 148%, тогда как transformers и peft выросли на 16%, а diffusers — на 21%. Все репозитории моделей выросли на 21,5%.
Агенты стали новым классом пользователей. Claude Code составил 44,4% трафика с меткой агента на Hub в июле 2026 года против 67,8% в апреле, тогда как Codex вырос с 10,4% до 20,8% за те же месяцы.
Статистика затрат, цен и финансирования
По данным Mozilla, инференс класса GPT-4 подешевел с примерно $20 до примерно $0,40 за миллион токенов за 36 месяцев — падение в 50 раз, которое отчёт связывает с конкуренцией открытых весов. Анализ Linux Foundation, цитируемый в отчёте, оценивает инференс закрытых моделей примерно в шесть раз дороже сопоставимой открытой модели. Mozilla превращает этот разрыв в оценку нереализованной годовой экономии в $24,8 млрд, если покупатели перенесут подходящие рабочие нагрузки на открытые веса. В качестве примера: Stripe сократила затраты на инференс на 73%, обрабатывая 50 млн API-вызовов в день, перенеся часть ИИ-работы на открытые модели.
Прейскуранты провайдеров иллюстрируют разброс. Сравнение Presenc AI за май 2026 года указывает DeepSeek V4 по $0,14 за миллион входных токенов против $3,00 у GPT-5.5 и Claude 4.7 Opus.
Источник: Presenc AI, Open Source vs Closed AI Market Share 2026, цены проверов за май 2026 года.
Меньшие закрытые модели близки к ценам открытых: GPT-5.5 mini оценивается в $0,15, а Gemini 3.1 Flash — в $0,075. В нижних сегментах цена сама по себе не отличает открытые модели от закрытых.
Компании, построенные на открытых моделях, начинают отчитываться о доходах. Отчёт Mozilla указывает Databricks с run-rate $5,4 млрд, а Mistral AI — с около $400 млн годовой регулярной выручки, двадцатикратным ростом за двенадцать месяцев. DeepSeek находится на уровне около $220 млн и привлекла $7,4 млрд при оценке выше $50 млрд. Mistral объявила о раунде Series C на €1,7 млрд 9 сентября 2025 года при постденежной оценке €11,7 млрд; раунд возглавила ASML. Zhipu AI и MiniMax обе готовят листинги в Гонконге в 2026 году. В мае 2026 года IBM и Red Hat пообещали $5 млрд на open-source инструменты и инфраструктуру для ИИ. Market.us прогнозирует рост рынка open-source моделей ИИ с $19,05 млрд в 2025 году до $23,08 млрд в 2026 году, примерно на 21%.
Лицензии показывают, откуда доходы не поступают. Из 178 китайских релизов свыше 20 млрд параметров в 2026 году 59% используют Apache 2.0 и 22% — MIT. Для американских релизов того же размерного диапазона 29% используют Apache или MIT, 41% — собственные условия, а 30% не указывают ничего. Hugging Face отмечает, что некоторые из крупнейших недавних релизов, такие как Kimi K3 и Qwen 3.8 2.4T, начали добавлять ограничения на некоммерческое использование или условия разделения выручки — картина лицензирования меняется.
Источники
- The ATOM Report (arXiv)
- OpenRouter, State of AI
- Hugging Face, State of Open Source on Hugging Face: Spring 2026
- State of Open Source AI (Mozilla)
- BenchLM, Open Source LLM Statistics (2026)
- Hugging Face, State of Open Models: Summer 2026 Observations
- TechnologyChecker, Open-Source AI Adoption 2026
- Tech Insider, Open-Source AI Powers 33% of Use, Just 4% of Revenue
- Presenc AI, Open Source vs Closed AI Market Share 2026
- Command Linux, Open-Source AI Model Download Statistics 2026
Статья первоначально опубликована на Blockonomi.

