ChatGPT Images 2.5 против Nano Banana 2: сравнение в шести категориях
Ключевые выводы
- •ChatGPT Images 2.5 и Nano Banana 2 выиграли по три категории каждая.
- •По заявлению OpenAI, новая модель может снизить задержку генерации изображений до 50% по сравнению с Images 2.0.
- •Тест показал, что ChatGPT Images 2.5 больше не демонстрирует желтый оттенок и сильную чрезмерную резкость, характерные для предыдущих поколений.
- •Nano Banana 2 выиграла тест на плотность текста и хронологию Bitcoin после орфографической и датовой ошибок ChatGPT Images 2.5.
- •OpenAI добавила Sketch, обмен запросами, комментарии к отдельным областям, шаблоны форматов и новые уровни качества high и max в API.
OpenAI запустила ChatGPT Images 2.5 8 сентября, пообещав более четкие детали, насыщенные текстуры, естественное освещение, более точное редактирование и снижение задержки генерации изображений до 50% по сравнению с Images 2.0.
В сравнении по шести категориям Nano Banana 2 выиграла три теста, а ChatGPT Images 2.5 — остальные три. Результаты определялись не столько очевидной разницей в качестве, сколько небольшими проверяемыми ошибками, включая орфографическую ошибку и неверную дату в инфографике, созданной на основе исследования.
OpenAI заявляет, что задержка снизилась до 50% по сравнению с Images 2.0. Компания также добавила две модели в API: GPT-Image-2.5 Flare — быстрый вариант по умолчанию, и GPT-Image-2.5 Sunburst, предназначенную для высокоточного редактирования.
Это сравнение продолжает предыдущий тест, опубликованный в мае, когда GPT Image 2 и Nano Banana 2 обменялись победами в восьми категориях. GPT Image 2 выиграла больше категорий, но при наличии множества одновременных ограничений в запросе создавала характерный артефакт чрезмерной резкости. Это породило вопрос о следующей модели: сможет ли OpenAI исправить проблему?
В новом раунде тот же оценщик использовал шесть категорий, перенесенных из предыдущих тестов или адаптированных на их основе, и отправил обеим моделям одинаковые запросы. Со стороны Google тестировалась Nano Banana 2 — так компания называет Gemini 3.1 Flash Image, а не более медленную и обстоятельную Nano Banana Pro. Таким образом, сравнивались новая быстрая и ориентированная на точность модель OpenAI и аналогичное предложение Google.
Что изменилось в GPT-Image-2.5
Ранее модели изображений OpenAI были связаны с характерными недостатками. Модель, лежавшая в основе оригинальной GPT Image 1, приобрела устойчивый теплый желтый оттенок, который пользователи прозвали «фильтром мочи». OpenAI так и не объяснила и не исправила этот оттенок полностью.
GPT Image 2 заменила эту проблему другой: запросы с чрезмерным количеством наложенных ограничений могли приводить к изображениям с сильной чрезмерной резкостью и плотными артефактами, напоминающими результат чрезмерной обработки.
В этом тесте ни одна из проблем не проявилась. Изображения, созданные ChatGPT Images 2.5, сохраняли цветовой баланс и детализацию даже при максимальной сложности запросов. Желтый оттенок и чрезмерная резкость, характерные для двух предыдущих поколений, отсутствовали. Улучшение особенно заметно в тестах со стимпанком и портретом: эти изображения оказались наиболее фотографически цельными среди результатов ChatGPT за три поколения моделей.
OpenAI также представила функции рабочего процесса, которые не отражаются в простом сравнении изображений. Sketch позволяет пользователям прямо в ChatGPT набросать примерную компоновку, которую модель использует как ориентир при генерации. Среди других нововведений — обмен запросами, встроенные комментарии к отдельным областям изображения и шаблоны форматов для постеров и товаров. В API уровни качества теперь простираются от low до новых high и max — выше максимального уровня Images 2.0.
Вот как две модели показали себя в шести категориях.
Плотность текста: сцена с Kellerman’s Hardware
В первом тесте изображена мрачная улица на перекрестке в 2 часа ночи, где почти каждая поверхность содержит читаемый текст: выцветшую вывеску, граффити, нанесенные аэрозольной краской, виниловые буквы на витрине, порванный концертный плакат, трафаретную надпись на бордюре и телефон-автомат, покрытый наклейками.
Nano Banana 2 чисто отобразила почти весь текст. Главной ошибкой стала наклейка на телефоне-автомате, где собственная надпись повторялась в искаженном виде. Это небольшая ошибка, которую легко не заметить.
ChatGPT Images 2.5 добавила деталь, которую пропустила Nano Banana 2: фонарь с перекрывающими друг друга пристегнутыми скобами листовками, порванными и выцветшими, как было указано в запросе. Однако надпись в стиле уличного искусства выглядела как «STILLL HERE» с лишней буквой L. Апостроф в «KELLERMAN’S» на выцветшей вывеске также отсутствовал или был нечитаемым.
Хотя OpenAI создала в целом более реалистичную сцену, в тесте на точность отображения текста модель допустила две отдельные ошибки читаемости. В этой категории победила Nano Banana 2.
Победитель: Nano Banana 2
Пространственное восприятие: стимпанковская часовая башня
Этот тест аэрокомпозиции требовал создать сцену с пятью планами глубины и массивной часовой башней. На ее циферблатах должны были отображаться разные часы римскими цифрами, а еще шесть текстовых элементов — распределяться от переднего плана к заднему.
ChatGPT Images 2.5 с заметным преимуществом создала более атмосферное изображение. С крыш поднимался видимый пар, через средний план проходила река, а тональный диапазон был богаче на всех пяти планах глубины. Текст также читался лучше.
У Nano Banana 2 атмосфера получилась более плоской. На двух видимых циферблатах действительно были четко отображены римские цифры — XII, III, VI и IX, — но стрелки на обоих часах находились примерно в одинаковых положениях, вопреки требованию запроса показать разное время.
ChatGPT Images 2.5 победила благодаря более точному следованию инструкциям без ущерба для реалистичности.
Победитель: ChatGPT Images 2.5
Иллюстрация: аниме-медиум
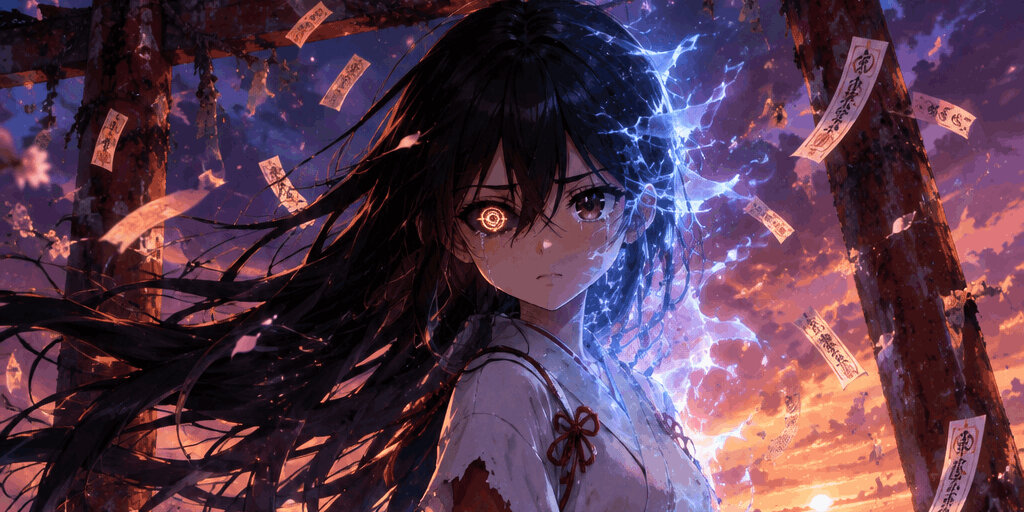
В запросе требовалось создать ключевой кадр в стиле Studio Ufotable: девушка превращается в духовную энергию у ворот тории, рядом находится девятихвостая кицунэ-лисица, а на заднем плане — сумеречное небо в стиле, ассоциируемом с Макото Синкаем.
ChatGPT Images 2.5 создала самое выразительное небо за всю серию тестов. В изображении были видны солнечный диск, отражение в воде и силуэт гор, благодаря чему сравнение с работами Синкаи выглядело оправданным. Асимметричные глаза персонажа также получились удачно.
Модель менее буквально интерпретировала требование, чтобы девушка «растворялась в энергии». Вместо описанного плавного полупрозрачного растворения она представила этот эффект как электрические разряды, проходящие через волосы. Тонкий сине-белый энергетический след Nano Banana 2 точнее соответствовал этой конкретной инструкции.
Ни одна модель не создала убедительную девятихвостую лисицу. Тем не менее ChatGPT Images 2.5 победила по общему визуальному впечатлению.
Победитель: ChatGPT Images 2.5
Реализм: архитектор на крыше
Этот кинематографический портрет содержал множество независимых ограничений: бежевый тренч, круглые очки, чертежи именно в левой руке, освещение золотого часа, малую глубину резкости и зернистость пленки.
ChatGPT Images 2.5 создала выразительное освещение: солнечный диск находился прямо за героиней, а микротекстура кожи была выполнена очень хорошо. Кожа выглядела слишком гладкой, но окружающая сцена казалась весьма реалистичной и напоминала фотографию, снятую на аналоговую камеру.
Добавление инструкций, которые обычно снижают фотографическое качество, неожиданно повысило реалистичность изображения. В одной из генераций использовались такие ключевые слова, как «realistic, highlights, crushed shadows, uneven flash, blown out skin tones, candid moment, shot on a phone camera».
Nano Banana 2 сохранила более полную композицию и разместила чертежи в правой руке героини, а не в требуемой левой. Однако модель добавила читаемую надпись на чертеже: «PROJECT: 124 DUANE ST» — деталь, которую большинство генераций пропустили.
Nano Banana 2 выиграла сравнение одиночных изображений, тогда как ChatGPT Images 2.5 сочли более сильной при повторных итерациях.
Победитель: Nano Banana 2 в одной генерации; ChatGPT Images 2.5 в повторных итерациях
Агентное исследование: хронология Bitcoin
Обе платформы могут исследовать тему перед созданием изображения. В тесте требовалось сделать широкоформатную хронологию истории Bitcoin в стиле детского рисунка с жестким требованием к фактической точности. Это была самая важная категория сравнения, и именно здесь разрыв между моделями оказался максимальным.
ChatGPT Images 2.5 создала аккуратную инфографику из двух рядов с множеством конкретных дат, но одна из них оказалась неверной. Модель указала 2023 годом одобрения Bitcoin-ETF в США. Комиссия по ценным бумагам и биржам США одобрила первые спотовые Bitcoin ETF 10 января 2024 года — на полный год позже. В исходном материале отмечалось, что расхождение может быть связано с особенностями интерпретации, поскольку фьючерсные ETF были одобрены в том году.
Nano Banana 2 создала менее структурированную хронологию с похожими событиями. Для одобрения ETF и четвертого халвинга модель использовала диапазон «2023–2024», а не утверждала один неверный год. Поэтому ни одна из указанных ею дат технически не была ложной.
Nano Banana 2 победила, поскольку уверенно указанная неверная дата имеет большее значение в тесте, предназначенном для оценки того, дает ли «агентное рассуждение» точный результат исследования.
Победитель: Nano Banana 2
Абстрактные концепции: запрос из выдуманных слов
Финальный запрос почти полностью состоял из выдуманных терминов: «A woman eating shmfiyxl in Lyxin. Next to her, her Lymglsushing plays Lakishkark.» У блюда, места, спутника и занятия не было словарных определений, поэтому каждой модели пришлось самостоятельно придумать их значения и решить, как их представить.
ChatGPT Images 2.5 встроила бессмысленные слова прямо в сцену в виде видимого текста. «Lyxin» появилось на неоновой вывеске над стильным футуристическим рестораном, а «Lakishkark» было напечатано на коробке настольной игры, в которую играло инопланетное существо за столом женщины. Превратив выдуманные термины в читаемые вывески, модель сделала их конкретными, а не абстрактными.
Nano Banana 2 выбрала другой подход. Она создала теплую, культурно конкретную сцену с рыночным прилавком в Гватемале, женщиной в традиционном уипиле и похожим на орка существом, играющим на гибридном струнно-духовом инструменте. Модель интерпретировала слово «plays» как игру на музыкальном инструменте, а не как участие в игре, что стало другим, но допустимым прочтением запроса.
Однако изображение никак конкретно не связывало сцену с «Lyxin» или «Lakishkark», и ни одно из выдуманных слов не появилось в виде видимого текста. ChatGPT Images 2.5 победила, поскольку превращение неопределенных понятий в читаемые обозначения было более буквальным ответом на запрос без заданных значений.
Победитель: ChatGPT Images 2.5
Вердикт
Nano Banana 2 выиграла три из шести категорий, поэтому сравнение фактически завершилось вничью. Результат зависит от ожиданий пользователя и способа работы с моделью.
ChatGPT Images 2.5 исправила проблему чрезмерной резкости, которая затрагивала ее предшественницу. Иллюстрация этой модели, возможно, стала самым визуально впечатляющим отдельным изображением, созданным любой из двух моделей за два полноценных раунда тестирования.
Выбор модели зависит от задачи: для изображений с большим количеством текста и основанных на исследованиях важнее точная читаемость и проверка фактов, тогда как иллюстрации и рабочие процессы с повторными генерациями раскрывают другие сильные стороны, показанные в этом тесте. Сравнение не определяет универсального победителя, но демонстрирует, почему оценивать модели изображений нужно не только по визуальной привлекательности одного изображения.
Главное различие заключалось не в общем качестве, а в серии небольших проверяемых деталей: орфографической ошибке в насыщенной текстом сцене, неверном годе в инфографике на основе исследования и других узких промахах в следовании инструкциям. С точки зрения общей эстетики и качества изображений две модели были в целом сопоставимы.

