Modele AI open source w 2026 roku: liczby dotyczące pobrań, użytkowania i adopcji
Najważniejsze informacje
- •Qwen od Alibaba osiągnął 942,1 mln skumulowanych pobrań na Hugging Face do marca 2026 roku — około dwukrotność wyniku Lamy od Meta, 476,0 mln.
- •Według szacunków Mozilla modele otwarte obsługują około 33% aktywnego użytkowania AI, ale przechwytują tylko około 4% globalnych przychodów AI.
- •Otwarte modele z Chin wyprzedziły Stany Zjednoczone pod względem skumulowanych pobrań pod koniec lipca 2025 roku i na marzec 2026 roku prowadziły o 428 mln.
- •Tylko 51% zespołów pracujących z modelami otwartymi trafia na produkcję, wobec 63% dla modeli zamkniętych — lukę przypisuje się głównie brakującej infrastrukturze, a nie jakości modeli.
- •Koszty inferencji modeli klasy GPT-4 spadły około pięćdziesięciokrotnie w ciągu 36 miesięcy, z około 20 do 0,40 dolara za milion tokenów — spadek wiązany w raporcie z konkurencją otwartych wag.
Modele AI open source są dziś rutynowym elementem rozwoju oprogramowania. Deweloperzy je pobierają, budują na nich aplikacje i uruchamiają je na własnym sprzęcie. Kilka organizacji próbuje mierzyć tę aktywność, a ich liczby nie zawsze się zgadzają. Niniejszy raport zestawia główne dane obok siebie, obejmując pobrania, użycie tokenów, zmiany regionalne, koszty, ankiety wśród deweloperów oraz finansowanie firm. Każda liczba zawiera swoje źródło, datę oraz uwagę o tym, co faktycznie mierzy.
Jedno zastrzeżenie dotyczy każdej poniższej metryki. Pobranie to żądanie pliku, a nie osoba. Liczba tokenów mierzy wykonaną pracę, a nie liczbę kopii. Większość otwartych modeli dokładniej określać jako modele o otwartych wagach: wytrenowane parametry są publiczne, ale dane treningowe i kod często nie są. Liczby opisują zatem różne warstwy adopcji: dystrybucję, inferencję, eksperymentowanie i wdrożenia produkcyjne. Należy czytać je łącznie, a nie traktować jako zamiennych miar udziału w rynku.
Najważniejsze liczby w skrócie:
- Qwen osiągnął 942,1 mln skumulowanych pobrań na Hugging Face do marca 2026 roku; Llama osiągnęła 476,0 mln.
- DeepSeek obsłużył 14,37 bln tokenów na OpenRouter między listopadem 2024 a listopadem 2025 roku.
- Według Mozilla modele otwarte obsługują około 33% aktywnego użytkowania AI, ale generują około 4% przychodów AI.
- 79% deweloperów dodających funkcje AI korzysta z modeli otwartych, wobec 71% w przypadku modeli zamkniętych.
- Zespoły korzystające z modeli otych rzadziej trafiają na produkcję: 51% wobec 63% dla modeli zamkniętych.
Statystyki pobrań modeli AI open source według rodzin modeli
Raport ATOM śledzi około 1 500 otwartych modeli językowych na Hugging Face i definiuje pobranie jako każde żądanie HTTP do punktu końcowego pliku modelu, w tym automatyczne pobrania przez narzędzia takie jak transformers czy curl.
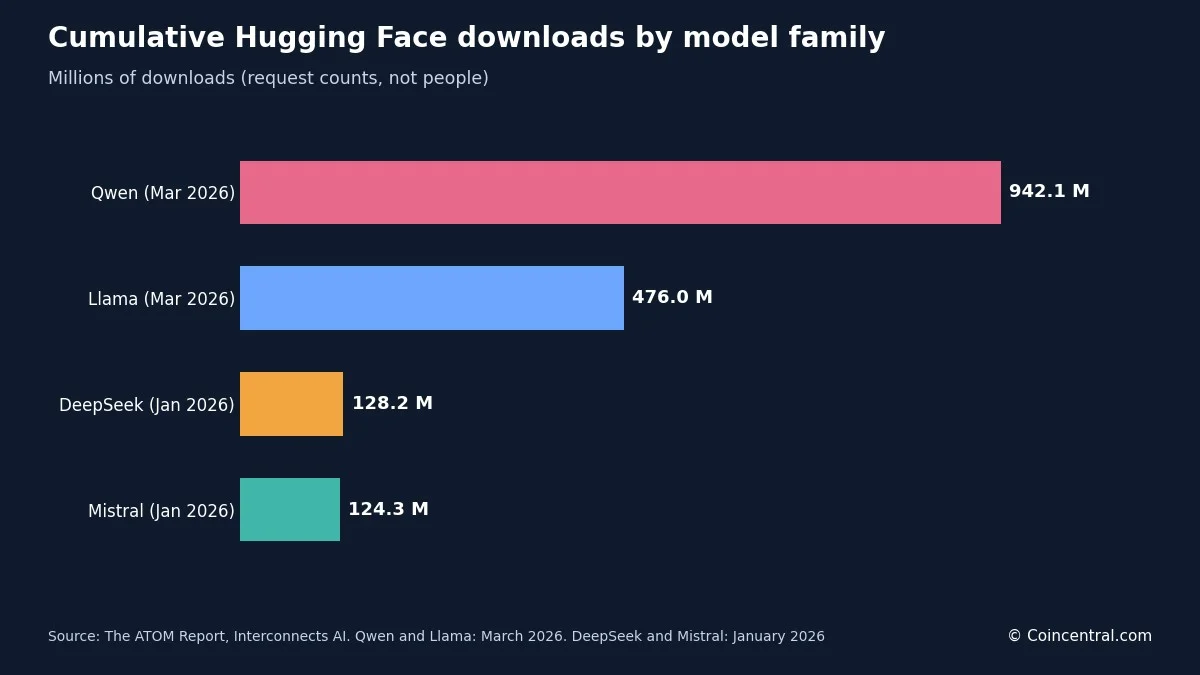
Rodzina Qwen od Alibaba skumulowała 942,1 mln pobrań do marca 2026 roku, podczas gdy rodzina Llama od Meta osiągnęła 476,0 mln w tym samym miesiącu. Qwen po raz pierwszy wyprzedził Llamę we wrześniu 2025 roku, gdy wynosiły odpowiednio 325,4 mln i 323,7 mln. Sześć miesięcy później różnica wzrosła do 466,1 mln: Qwen dodał w tym okresie około 617 mln pobrań, podczas gdy Llama około 152 mln.
Źródło: The ATOM Report, Interconnects AI, skumulowane pobrania na Hugging Face.
DeepSeek i Mistral ustępują dwóm czołowym z dużą przewagą. DeepSeek wyprzedził Mistrala w styczniu 2026 roku, osiągając 128,2 mln pobrań wobec 124,3 mln. Mistral wcześniej prowadził w tej stawce — jego udział w nowych modelach pochodnych osiągnął szczyt 57% w grudniu 2023 roku dzięki modelom Mistral 7B i Mixtral. Udział pochodnych Meta osiągnął szczyt 44% w sierpniu 2024 roku, a do lutego 2026 roku spadł do 11%.
Nowsze amerykańskie laboratoria startują z dużo mniejszej bazy. Nemotron od NVIDIA zanotował 30,7 mln pobrań między sierpniem 2025 a marcem 2026 roku, OLMo od Allen Institute for AI 14,8 mln, a Granite od IBM 8,6 mln.
Ogłoszenia firmowe rządzą się innymi zasadami. Meta podała, że Llama przekroczyła 1 mld pobrań 18 marca 2025 roku. Google oświadczył, że Gemma przekroczyła 1 mld 20 sierpnia 2026 roku, a inżynier Google zauważył, że licznik nie obejmuje integracji z Androidem i Chrome. Żadna z tych firmowych liczb nie została niezależnie zweryfikowana, a licznik ATOM dla Lamy obejmuje tylko śledzone modele generujące tekst na Hugging Face, więc obu zestawów danych nie można bezpośrednio porównywać.
O przewagi Qwena decyduje jego miesięczny wolumen. W lutym 2026 roku sam Qwen wygenerował 153,6 mln pobrań, podczas gdy kolejnych osiem organizacji tworzących otwarte modele łącznie 71,2 mln.
Statystyki pobrań modeli AI open source według regionów
ATOM przypisuje każdy model do Stanów Zjednoczonych, Chin lub Europy według siedziby organizacji wydającej model. Łączna liczba śledzonych pobrań osiągnęła 2,04 mld do marca 2026 roku, wobec 339 mln rok wcześniej.
Źródło: The ATOM Report, Interconnects AI, skumulowane pobrania na Hugging Face.
Żaden region się nie skurczył. W marcu 2025 roku Stany Zjednoczone prowadziły nad Chinami o80 mln pobrań; do marca 2026 roku Chiny prowadziły o 428 mln, a ATOM umieszcza moment przeskoku pod koniec lipca 2025 roku.
Dane ankietowe wskazują w tym samym kierunku. Ankieta deweloperska Mozilla wykazała użycie modeli otwartych na poziomie 89% w Wielkich Chinach i Azji Wschodniej — najwyższy wynik spośród wszystkich regionów — wobec 70% w Europie Zachodniej. Ruch na OpenRouter pokazuje podobną zmianę: według analizy Mozilla modele open-weight z Chin wzrosły z poniżej 2% tygodniowego ruchu pod koniec 2024 roku do 45% w kwietniu 2026 roku.
Letni raport Hugging Face za 2026 rok przyjrzał się rozmiarowi modeli. W prawie każdym miesiącu 2026 roku największy otwarty model wydany przez chińskie laboratorium był większy niż jakikolwiek model z laboratorium amerykańskiego. Chiński miesięczny pułap mieścił się w przedziale od 754 mld do 2,78 bln parametrów, podczas gdy modele amerykańskie w pięciu z siedmiu miesięcy pozostawały poniżej 130 mld parametrów. AMD i NVIDIA wydały w 2026 roku po ponad 200 nowych repozytoriów modeli — więcej niż jakakolwiek inna organizacja — a trzecie miejsce zajmuje LiquidAI z około 100.
Statystyki użycia tokenów dla modeli otwartych
Pobrania mierzą, jak często wagi są kopiowane; tokeny mierzą, ile pracy wykonuje model. OpenRouter i a16z przeanalizowali ponad 100 bln tokenów rzeczywistego ruchu platformy od listopada 2024 do listopada 2025 roku. DeepSeek obsłużył 14,37 bln tokenów, przed Qwenem z 5,59 bln i Metą Llama z 3,96 bln — inna kolejność niż w rankingu pobrań, gdzie Qwen prowadzi z dużą przewagą.
Źródło: OpenRouter i a16z, State of AI, tokeny routowane na OpenRouter, listopad 2024 – listopad 2025.
Pod koniec 2025 roku modele open-weight odpowiadały za około jedną trzecią użycia OpenRouter. W całym rocznym oknie otwarte modele z Chin odpowiadały średnio za 13,0% tygodniowego wolumenu tokenów, otwarte modele z reszty świata 13,7%, a proprietarne modele z reszty świata 70%.
Seria OpenRouter prowadzona przez ATOM pokazuje, jak szybko mogą się zmieniać udziały. DeepSeek V3 i R1 łącznie stanowiły aż 75,6% tokenów inferencji modeli otwartych w czerwcu 2025 roku, by do stycznia 2026 roku spaść do 31,1%. Udział Meta spadł ze szczytu 37,4% w styczniu 2025 roku do zera w sierpniu 2025 roku. Przywództwo w tym wskaźniku może zmienić się w ciągu kilku miesięcy.
Presenc AI, korzystając z innego zestawu źródeł, raportuje mniejszy udział modeli otwartych: około 15% tokenów inferencji w styczniu 2026 roku, wobec około 1% rok wcześniej. W tej estimacie DeepSeek odpowiada za około 6%, Qwen około 5%, a Llama około 3%.
Open source kontra zamknięte AI: użycie, przychody i wydajność
Mozilla opublikowała swój pierwszy raport State of Open Source AI w lipcu 2026 roku. Wykazał on, że modele otwarte obsługują około 33% aktywnego użytkowania AI, ale przechwytują około 4% globalnych przychodów AI; modele zamknięte odpowiadają za pozostałe 67% użycia i 96% przychodów. Rozbieżność wynika ze sposobu zarabiania modeli otwartych: nikt nie płaci opłaty licencyjnej za token za uruchamianie otwartych wag, więc przychody trafiają do tego, kto hostuje model — często jest to infrastruktura samego nabywcy.
Inne źródła podają niższy udział w użyciu. MIT Sloan, cytowany przez TechnologyChecker, szacuje modele zamknięte na około 80% użycia modeli i podaje, że modele otwarte osiągają około 90% wydajności modeli zamkniętych na etapie premiery.
Luka wydajnościowa zmieniała się w czasie. Śledzenie Chatbot Arena przez Mozilla pokazuje spadek średniej luki z około 8,04% do aż 0,5% w sierpniu 2024 roku. Następnie ponownie się powiększyła po wydaniu nowych modeli rozumujących przez zamknięte laboratoria i w marcu 2026 roku wynosiła 3,3 punktu procentowego.
BenchLM używa innej skali. Na dzień 20 października 2026 roku 12 z jego 50 najlepszych modeli (24%) było open-weight, podobnie jak 494 ze śledzonych 972 modeli (51%). Jego najlepszy otwarty model, MiMo-V2.6-Pro od Xiaomi, zdobył 73,66 na 100 punktów i zajął 12. miejsce — 13,03 punktu za najlepszym modelem proprietarnym, Claude Opus 5.5. BenchLM podaje lukę Arena Elo między najlepszym modelem zamkniętym a najlepszym otwartym na 36,8 punktu na dzień 15 października 2026 roku, wobec 29,2 punktu około rok wcześniej. Strona opisuje to jako zawężanie, ale wydrukowane liczby pokazują większą lukę, więc ten trend należy odczytywać ostrożnie.
Luka zależy też od zadania. Porównanie Presenc AI z maja 2026 roku pokazuje niemal parzystość w testach wiedzy i kodowania oraz szeroką przewagę modeli zamkniętych w trudnych testach rozumowania.
Źródło: Presenc AI, Open Source vs Closed AI Market Share 2026. Wartości są przybliżone.
Pojedyncze wyniki mogą łamać ten schemat. GLM-5.2 od Z.ai zdobył 81,0 na Terminal-Bench 2.1 wobec 83,4 dla GPT-5.5, a na SWE-bench Pro uzyskał 62,1 wobec 58,6 dla GPT-5.5. Zestaw danych Mozilla przed pojawieniem się GLM-5.2 wykazywał najlepszy otwarty model na poziomie 67,9 na Terminal-Bench 2.1 — dane raportu były już w dniu publikacji nieaktualne względem najnowszej premiery.
Statystyki adopcji deweloperskiej i użycia produkcyjnego
Raport Mozilla opiera się na ankiecie SlashData przeprowadzonej w maju 2026 roku wśród 1 494 deweloperów dodających funkcje AI do aplikacji.
Źródło: ankieta deweloperska Mozilla i SlashData 2026, przeprowadzona w maju2026 roku. Dwa pierwsze wiersze się nakładają.
Na etapie produkcji grupy się rozchodzą. Wśród zespołów pracujących z modelami otwartymi 51% trafia na produkcję, wobec 63% dla modeli zamkniętych. Strona raportu Mozilla podaje wartość otwartą jako 53%, podczas gdy wpis na blogu firmy podaje 51%. Alvaro Ruiz Cubero ze SlashData przypisuje tę lukę brakującej infrastrukturze, a nie jakości modeli.
Na pytanie, co blokuje projekty oparte na modelach otwartych, deweloperzy najczęściej wskazywali koszt infrastruktury — 27%, następnie bezpieczeństwo i zgodność — 26%, utrzymanie i aktualizacje — 24% oraz złożoność wdrożeń — 23%. Cztery odpowiedzi mają zbliżoną wagę, więc żadna pojedyncza poprawka nie rozwiązuje problemu.
Użycie zależy też od rodzaju pracy. Według estymat Presenc AI około 94% pracy na krawędzi i na urządzeniach korzysta z otwartego modelu, z udziałem około 85% w pracy wrażliwej na koszty o dużym wolumenie i około 71% w pracy z danymi wrażliwymi w dziedzinach takich jak prawo, finanse i ochrona zdrowia.
Źródło: Presenc AI, Open Source vs Closed AI Market Share 2026.
Wyniki ankiet zależą od sposobu zadania pytania. Presenc AI podaje, że około 89% przedsiębiorstw używa co najmniej jednego modelu open source na produkcji, podczas gdy Linux Foundation, cytowana przez TechnologyChecker, wykazała, że 63% organizacji korzysta z AI open source, a 89% używa jakiegoś open source gdziekolwiek w swoim stacku AI.
Widoczne wdrożenia webowe są znacznie niższe. TechnologyChecker przeskanował w maju 2026 roku ponad 50 mln domen i wykrył Botpress — najczęściej spotykany przez niego framework AI open source — na 1 558 domenach, wobec 52 682 dla zamkniętego API OpenAI i 1 349 dla Dialogflow od Google. Wśród 899 firm powiązanych z wdrożeniem Botpress 64% miało 10 lub mniej pracowników, 81% mniej niż 50, a około 5% tysiąc lub więcej. Stany Zjednoczone odpowiadały za około 23% wykrytych wdrożeń, następnie Hiszpania z 6,9% i Indie z 6%. TechnologyChecker zaznacza, że jego metoda nie widzi narzędzi backendowych, takich jak transformers, LangChain czy Ollama; jego liczniki odzwierciedlają wyłącznie warstwę widoczną w przeglądarce.
Statystyki ekosystemu Hugging Face
Wiosenny raport Hugging Face za 2026 rok podał, że platforma w 2025 roku urosła do 13 mln użytkowników, ponad 2 mln publicznych modeli i ponad 500 tys. publicznych zbiorów danych. Raport letni, obejmujący styczeń–sierpień 2026 roku, odnotował wzrost publicznych repozytoriów modeli z 2,43 mln do 2,96 mln, zbiorów danych z 711 tys. do 1 mln, a Spaces z 1,00 mln do 1,44 mln.
Uwaga jest silnie skoncentrowana. Raport wiosenny wykazał, że około połowa wszystkich modeli miała łącznie mniej niż 200 pobrań, a200 najlepszych modeli — 0,01% całości — odpowiadało za 49,6% wszystkich pobrań. Raport letni podał udział modeli poniżej 200 pobrań w całym okresie na poziomie 85,6% oraz że 1,5% repozytoriów odpowiada za 99,2% pobrań. Oba raporty liczą inaczej i obejmują różne okresy, ale oba pokazują ten sam kształt: niewielka grupa modeli przechwytuje niemal cały ruch.
Stanford AI Index 2026 liczy około 5,6 mln projektów związanych z AI na GitHubie i Hugging Face, z których tylko 206 880 (3,7%) ma 10 lub więcej gwiazdek. Przesyłki modeli na Hugging Face wzrosły ponad trzykrotnie między 2023 a 2025 rokiem, osiągając 332 tys. w pojedynczym kwartale.
Źródło: Hugging Face, State of Open Source on Hugging Face: Spring 2026, opublikowane 17 marca 2026 roku.
Średnia rosła znacznie szybciej niż mediana. Hugging Face przypisuje podciąganie górnej granicy kwantyzacji i architekturom mixture-of-experts, podczas gdy użycie małych modeli pozostaje płaskie. To wciąż małe modele zbierają większość pobrań: modele poniżej 1 mld parametrów odpowiadają za 83% pobrań w całej historii, a modele powyżej 100 mld za 1%, przy czym w samych pobraniach za 2026 rok 3% przypadło na modele powyżej 70 mld parametrów.
Polubienia i pobrania mierzą co innego. TOP 25 repozytoriów według pobrań w 2026 roku i TOP 25 według polubień miało dokładnie jedną wspólną pozycję. Model all-MiniLM-L6-v2 był pobierany 1,55 mld razy w siedem miesięcy i ma 5 156 polubień.
Qwen stał się bazą, na której budują inni. Modele oparte na Qwenie odpowiadają za 151 448 pochodnych na Hubie — 2,6 razy więcej niż łączna liczba Mety i 4,7 razy więcej niż same repozytoria Llamy — z Googlem na drugim miejscu przy 82 506. Liczba pochodnych Qwena rosła o około 180–210 nowych repozytoriów dziennie w pierwszych siedmiu miesiącach 2026 roku.
Uruchamianie lokalne podąża za tym samym wzorcem. Qwen odnotowuje 39,6 mln pobrań GGUF miesięcznie, wobec 20,8 mln dla Gemmy i 7,5 mln dla Lamy. GGUF to format plików używany przez lokalne runtime'y, takie jak llama.cpp.
Najszybszy wzrost notuje warstwa runtime. Repozytoria korzystające z biblioteki gguf wzrosły o 464%, lerobot o 194%, a mlx od Apple o 148%, podczas gdy transformers i peft wzrosły o 16%, a diffusers o 21%. Wszystkie repozytoria modeli urósł o 21,5%.
Agenci wyłonili się jako nowa klasa użytkowników. Claude Code stanowił 44,4% ruchu otagowanego jako agent na Hubie w lipcu 2026 roku, w dół z 67,8% w kwietniu, podczas gdy Codex wzrósł w tym samym okresie z 10,4% do 20,8%.
Statyst kosztów, cen i finansowania
Według Mozilla inferencja klasy GPT-4 spadła z około 20 do około 0,40 dolara za milion tokenów w ciągu 36 miesięcy — pięćdziesięciokrotny spadek, który raport wiąże z konkurencją otwartych wag. Analiza Linux Foundation cytowana w raportie szacuje inferencję modeli zamkniętych na około sześciokrotność kosztu porównywalnego modelu otwartego. Mozilla przekłada tę lukę na estymatę 24,8 mld dolarów niezrealizowanych rocznych oszczędności, gdyby nabywcy przenieśli kwalifikujące się obciążenia na otwarte wagi. Jako przykład Stripe obniżył koszty inferencji o 73% przy obsłudze 50 mln wywołań API dziennie dzięki przeniesieniu części swojej pracy AI na modele otwarte.
Cenniki dostawców obrazują rozpiętość. Porównanie Presenc AI z maja 2026 roku podaje DeepSeek V4 po 0,14 dolara za milion tokenów wejściowych, wobec 3,00 dolarów za GPT-5.5 i Claude 4.7 Opus.
Źródło: Presenc AI, Open Source vs Closed AI Market Share 2026, ceny dostawców z maja 2026 roku.
Mniejsze modele zamknięte mieszczą się blisko cen otwartych: GPT-5.5 mini wyceniony jest na 0,15 dolara, a Gemini 3.1 Flash na 0,075 dolara — w niższych segmentach sama cena nie odróżnia modeli otwartych od zamkniętych.
Firmy zbudowane na modelach otwartych zaczynają raportować przychody. Raport Mozilla wymienia Databricks z run-rate 5,4 mld dolarów i Mistral AI z około 400 mln dolarów rocznego przychodu powtarzalnego — dwudziestokrotny wzrost w dwanaście miesięcy. DeepSeek jest na poziomie około 220 mln dolarów i zebrał 7,4 mld dolarów przy wycenie powyżej 50 mld. Mistral ogłosił rundę serii C o wartości 1,7 mld euro 9 września 2025 roku przy wycenie post-money 11,7 mld euro, z ASML na czele. Zhipu AI i MiniMax obaj dążą do debiutu w Hongkongu w 2026 roku. W maju 2026 roku IBM i Red Hat zobowiązały się przekazać 5 mld dolarów na narzędzia i infrastrukturę AI open source. Market.us prognozuje wzrost rynku modeli AI open source z 19,05 mld dolarów w 2025 roku do 23,08 mld w 2026 roku, czyli około 21%.
Licencje wskazują, skąd zwrot nie pochodzi. Wśród 178 chińskich wydań powyżej 20 mld parametrów w 2026 roku 59% używa Apache 2.0, a 22% MIT. Dla wydań amerykańskich w tym samym przedziale rozmiarów 29% używa Apache lub MIT, 41% stosuje własne warunki, a 30% niczego nie deklaruje. Hugging Face zauważa, że niektóre z największych niedawnych wydań, takie jak Kimi K3 i Qwen 3.8 2.4T, zaczęły dodawać ograniczenia niekomercyjne lub warunki podziału przychodów — obraz licencjonowania się zmienia.
Źródła
- The ATOM Report (arXiv)
- OpenRouter, State of AI
- Hugging Face, State of Open Source on Hugging Face: Spring 2026
- State of Open Source AI (Mozilla)
- BenchLM, Open Source LLM Statistics (2026)
- Hugging Face, State of Open Models: Summer 2026 Observations
- TechnologyChecker, Open-Source AI Adoption 2026
- Tech Insider, Open-Source AI Powers 33% of Use, Just 4% of Revenue
- Presenc AI, Open Source vs Closed AI Market Share 2026
- Command Linux, Open-Source AI Model Download Statistics 2026
Ten artykuł został pierwotnie opublikowany na Blockonomi.

