Departament Sprawiedliwości USA popiera fair use OpenAI i ostrzega przed powstaniem oligopolu licencyjnego w AI
Najważniejsze informacje
- •Departament Sprawiedliwości złożył oświadczenie interesu, w którym argumentuje, że wykorzystywanie przez OpenAI chronionych prawem autorskim tekstów do trenowania modeli powinno być objęte dozwolonym użytkiem (fair use).
- •Rząd ostrzegł, że obowiązkowe licencjonowanie tekstów treningowych podniosłoby bariery wejścia, sprzyjając zamożnym korporacjom i ugruntowanym wydawcom, a zmarginalizowaniu mniejszych programistów.
- •Dokument nie zapewnia pełnej ochrony — odróżnia trenowanie od wyników odtwarzających chronione treści oraz od sposobu pozyskiwania danych treningowych.
- •The New York Times i dyrektor naczelna Authors Guild Mary Rasenberger skrytykowały stanowisko rządu, a sędzia Sidney Stein może je zignorować.
- •Goldman Sachs Research prognozuje, że globalne inwestycje związane z AI przekroczą w 2026 roku 1 bilion dolarów, w tym 581 miliardów w Stanach Zjednoczonych.
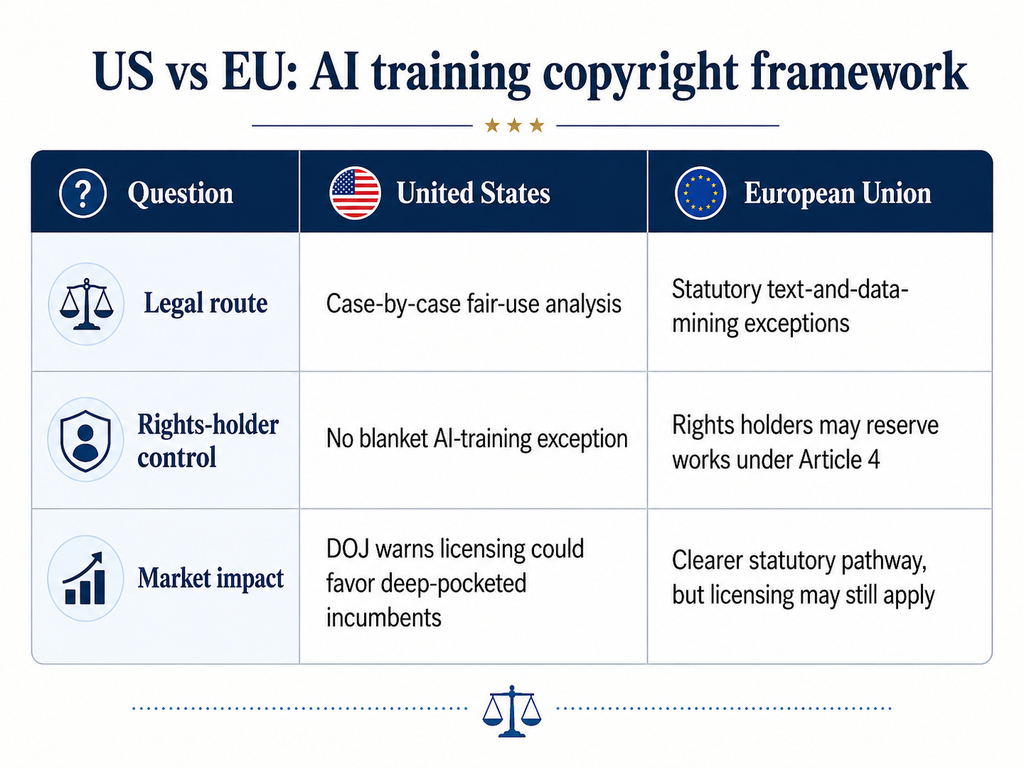
Departament Sprawiedliwości USA oświadczył we wtorek sądowi federalnemu na Manhattanie, że wykorzystywanie przez OpenAI chronionych prawem autorskim tekstów na etapie trenowania modeli powinno podlegać ochronie dozwolonego użytku (fair use) — stanowisko, które może przeobrazić ekonomikę globalnego przemysłu AI, ponieważ światowe inwestycje mają w tym roku przekroczyć 1 bilion dolarów.
W oświadczeniu interesu złożonym w skonsolidowanym procesie o naruszenie praw autorskich przeciwko OpenAI rząd ostrzegł, że jeśli programiści musieliby licencjonować teksty treningowe, jedynie zamożne korporacje byłyby w stanie nadal tworzyć przełomowe technologie AI.
Rząd przedstawił swój argument zarówno w ujęciu prawnym, jak i gospodarczym: obowiązkowe licencjonowanie mogłoby stworzyć poważne bariery wejścia na rynek, wzmocnić dominujące firmy technologiczne i przenieść większość wynikających z tego zysków do rąk ugruntowanych wydawców dysponujących największymi archiwami.
Oświadczenia interesu, takie jak to, nie rozstrzygają sprawy; pozwalają rządowi federalnemu zasygnalizować swoje stanowisko w kwestiach rozpatrywanych przez sąd, a sędziowie mogą je uwzględnić lub zignorować.
Dlaczego Waszyngton nazywa system licencyjny barierą wejścia
Według Departamentu Sprawiedliwości nałożenie kosztów na informacje wykorzystywane do trenowania AI może zmarginalizować mniejszych programistów na rzecz większych graczy. Jest to zgodne z raportem OECD, z którego wynika, że dostęp do mocy obliczeniowej, danych i specjalistycznej wiedzy na obecnym rynku AI jest już skonsolidowany i nadal będzie sprzyjał dobrze ugruntowanym firmom.
Waszyngton argumentował również, że mniejsi twórcy korzystają z niedrogich narzędzi AI. Autorzy mogą w szczególności wykorzystywać modele do generowania obrazów, na które inaczej nie byłoby ich stać, albo do znajdowania źródeł i perspektyw, które w przeciwnym razie by im umknęły.
Biuro Praw Autorskich USA (US Copyright Office) przyjęło jednak bardziej zniuansowane stanowisko, stwierdzając we własnym raporcie o trenowaniu generatywnej AI, że niektóre zastosowania treningowe mogą być objęte dozwolonym użytkiem, a inne nie — w zależności od źródła materiału, celu jego użycia oraz wpływu na rynek.
Argument o wykorzystaniu transformatywnym w centrum sporu
Departament Sprawiedliwości mocno oparł się na pierwszym czynniku dozwolonego użytku, określając trenowanie AI jako „nadzwyczajnie transformatywne”. W ramach amerykańskiego prawa autorskiego dozwolony użytek ocenia się, ważąc kilka ustawowych czynników — w tym cel i charakter użycia, charakter utworu, zakres wykorzystania oraz wpływ na rynek oryginału. Rząd argumentował, że kopie treningowe służą innemu celowi niż oryginalne artykuły i że korzyści z AI „znacznie przeważają nad jakąkolwiek szkodą konkurencyjną”.
Dokument nie zapewnia jednak programistom AI pełnej ochrony. Odróżnia trenowanie modeli od wyników odtwarzających chronione prawem autorskim treści, a także kwestie dotyczące sposobu pozyskiwania danych treningowych.
To rozróżnienie widać w sprawach kalifornijskich. Analiza Copyright Alliance spraw Bartz v. Anthropic i Kadrey v. Meta wskazuje, że oba sądy uznały trenowanie za transformatywne, lecz doszły do odmiennych wniosków w kwestii piractwa i szkody dla rynku.
Wiceminister sprawiedliwości Stanley Woodward Jr. nazwał dokument „historycznym oświadczeniem interesu”, wiążąc stanowisko administracji w sprawie prawa autorskiego z szerszym celem utrzymania pozycji USA w dziedzinie AI.
Bezpieczeństwo narodowe i wyścig z zagranicznymi rywalami
Dokument przedstawia również przepisy autorskie jako kwestię polityki przemysłowej i bezpieczeństwa narodowego, argumentując, że wyższe koszty rozwoju mogłyby stawiać firmy amerykańskie w gorszej pozycji wobec zagranicznych konkurentów.
Stawka jest znacząca. Goldman Sachs Research prognozuje ponad 1 bilion dolarów globalnych inwestycji związanych z AI w 2026 roku, w tym 581 miliardów dolarów w Stanach Zjednoczonych.
Unia Europejska wybrała inną drogę. Jej Dyrektywa o Jednolitym Rynku Cyfrowym przewiduje wyraźne wyjątki dotyczące tekstowego i danych eksplorowania danych, choć posiadacze praw mogą wyłączyć swoje utwory z niektórych form takiego eksplorowania. Amerykański wyrok w sprawie dozwolonego użytku zapadnie zatem na tle, w którym dwa największe rynki zachodnie już rozeszły się w sposobie regulowania danych treningowych AI.
Co dalej — wydawcy i sąd
The New York Times, który w 2023 roku pozwał OpenAI i Microsoft, odrzucił stanowisko Waszyngtonu.
Dyrektor naczelna Authors Guild Mary Rasenberger była równie krytyczna, mówiąc WIRED, że dokument jest „skrajnie rozczarowujący” — „pełen wadliwych argumentów i rażącego niezrozumienia doktryny dozwolonego użytku i prawa autorskiego”.
Berkeleyjska badaczka prawa autorskiego Pamela Samuelson oceniła interwencję rządu bardziej powściągliwie, nazywając ją „istotnym wydarzeniem”.
Sędzia Sidney H. Stein, przewodniczący sprawie, nie ma obowiązku stosować się do stanowiska Departamentu Sprawiedliwości.
Wyrok korzystny dla OpenAI mógłby nadal pozostawić nierozstrzygniętą kluczową kwestię: jak pozyskiwane są dane treningowe. Jak zauważyła Cryptopolitan, ugodowa kwota 1,5 miliarda dolarów płacona przez Anthropic autorom dotyczyła pirackich kopii materiałów treningowych — a nie samego aktu trenowania.
Ta różnica może mieć duże znaczenie. Nawet jeśli trenowanie zostanie uznane za dozwolony użytek, programiści AI nadal ponoszą istotne ryzyko prawne związane z nielegalnym pozyskiwaniem materiałów wykorzystywanych do budowy ich modeli.

