Coinbaseのベンチマーク、新型AIモデルはより多くの決済不正を見逃したと判明
重要ポイント
- •7,293ユーザーの16,140件のトランザクション(確認済み不正813件を含む)の過去データ再現において、Coinbaseがテストしたすべての新型モデルバージョンは、意思決定ポリシーを変更しないまま、旧バージョンよりリコール、F1、金額加重リコールが低下しました。
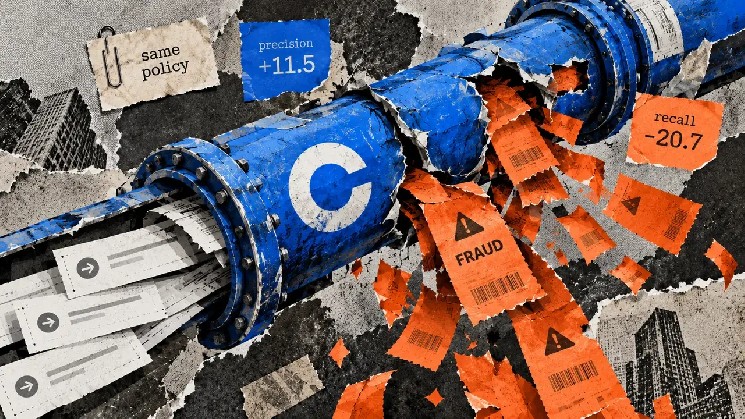
- •Sonnetのリコールは22.2ポイント、金額加重リコールは22.9ポイント低下した一方、GPTは精度が11.5ポイント上昇したもののリコールが20.7ポイント低下しており、単一の改善した指標が誤解を招きうることを示しています。
- •再現テストは顧客損失を立証するものではなく、Coinbaseは原因を特定しないまま性能劣化を識別できたと述べており、パターンの背後にあるメカニズムは未解明のままです。
- •10月8日の開示で、Coinbaseはポストトレーニング済みのQwen3.5-9Bモデルが4つの不正検出指標でOpus 4.5を上回り、F1が9.6ポイント改善、金額加重リコールが35.4ポイント上昇、エンドツーエンドの中央値レイテンシがOpus 4.5の1.515秒に対し0.683秒になったと報告しました。
- •Coinbaseは、決済プロバイダーに対し、まず実際の意思決定環境で候補モデルをテストし、その後、変更されたプロンプトや閾値を別途評価しながら、検出品質とともにレイテンシ、信頼性、コストを考慮することを推奨しています。
Coinbaseは10月7日、主要AIモデルファミリー3種の新型バージョンが、Onrampサービス向け決済スクリーニングの過去データ再現テストにおいて、意思決定ポリシーが変更されないまま、検出した不正決済の件数と不正額の割合が旧バージョンより少なかったと発表しました。ベンチマークレポートで詳述されたこの調査結果は、モデルをアップグレードすれば既存の決済スクリーナーが自動的に改善するという想定に疑問を投げかけるものです。
同社の評価では、7,293ユーザーにわたる16,140件のトランザクション(確認済みの不正トランザクション813件を含む)が再生されました。対象期間はリスクエージェントの展開前の9週間で、成熟した不正案件をすべて保持しつつ、正当なトラフィックをサンプリングしました。
各候補モデルは、固定されたガイダンスと、リスク分類を意思決定に変換する同一ポリシーの下で、直近のトランザクション行動をレビューしました。この設計により、スクリーニングシステムを再設計した場合との比較ではなく、既存のセットアップ内での意思決定モデルの挙動が分離されました。運用者にとって実務上重要なアップグレードのシナリオは、スクリーニングシステムをそのまま維持し、基盤のモデルだけを変更するというものです。
固定された過去データ再現で新型モデルが低成績
CoinbaseはOpus 4.5とOpus 5、Sonnet 4.6とSonnet 5、そしてGPT-5.4とGPT-5.6 (sol)を比較しました。新型バージョンはすべて、リコール、精度とリコールを組み合わせたF1スコア、金額加重リコールが低下しました。リコールはモデルが検出した不正案件の割合を、金額加重リコールは不正総額のうちどれだけを検出したかを測定します。
Sonnetのリコールは22.2ポイント低下し、金額加重リコールは22.9ポイント下落しました。Opusのリコールは0.8ポイント減少しました。両新型モデルはいずれも精度も低下しており、不正と判定したトランザクションのうち実際に不正だった割合が小さくなっています。
GPTは、単一の改善した指標がいかに誤解を招きうるかを示しました。精度は11.5ポイント上昇しましたが、リコールは20.7ポイント、金額加重リコールは21.8ポイント低下しました。不正フラグの精度は向上したものの、再現テストではより多くの不正案件と金額が検出を逃れました。
この再現テストは、当該バージョンの展開による客損失を立証するものではありません。Coinbaseはまた、原因を特定しないまま性能劣化を識別できたとも述べています。つまり、このパターンの背後にあるメカニズムは公開された研究では未解明のまま残されており、今後の追加分析で扱われる可能性のある論点となっています。
Coinbaseの以前のオンライン実験では、既存のモデルとルールのみの場合と、選択的なLLMレビューを追加した場合が比較されました。エージェントを活用したフローでは、不正トランザクションが30%減、不正額が22%減となりましたが、新型モデルバージョンの比較は行われていません。
SR-Fraudの研究者らは限界の記述において、独自データセットが公開できないため、独立した再現実験と一般化が制限されると述べています。関連する決済不正研究は9月23日に初公開され、10月のブログ記事に先立つ9月30日に改訂されました。
カスタムモデルの別の事例
10月8日の開示で、Coinbaseはポストトレーニングを施したQwen3.5-9Bモデルが4つの不正検出指標すべてでOpus 4.5を上回ったと報告しました。F1は9.6ポイント改善し、金額加重リコールは35.4ポイント上昇しました。同社は、不正と正当な事例のバランスを取る決定論的な報酬と過去の不正結果を用いてこのモデルを特化させました。
また、本番環境での計測では、エンドツーエンドのLLMリクエストの中央値レイテンシは0.683秒で、Opus 4.5の1.515秒と比べて相対的に55%短縮されました。高速な推論とベンチマークでの強力な検出性能は、それぞれ異なる評価から得られたものです。
両開示を併せて読むと、決済チームにとっての現実的な選択肢が見えてきます。フロンティアモデルのバージョン更新に追いつきつつ、それぞれを自社の意思決定環境で再検証するか、あるいはCoinbaseのように、より小型のモデルを過去の結果に基づいて特化させるかです。
決済プロバイダーにとってのアップグレードの問いは、候補モデルが実際の意思決定環境において不正検出範囲を改善するかどうかだとCoinbaseは述べています。同社は、まずその構成をテストし、その後、変更されたプロンプトや閾値を別途評価しながら、検出品質とともにレイテンシ、信頼性、コストを考慮することを推奨しています。

