ChatGPT Images 2.5対Nano Banana 2:6項目比較
重要ポイント
- •ChatGPT Images 2.5とNano Banana 2は、比較した6項目で3勝ずつとなった。
- •OpenAIによると、新モデルはImages 2.0と比べて画像生成レイテンシーを最大50%削減できる。
- •テストでは、ChatGPT Images 2.5に従来世代で見られた黄色い色かぶりや強い過度のシャープ化が確認されなかった。
- •Nano Banana 2は、ChatGPT Images 2.5がスペルと日付に関するミスを出した文字密度の高いテストとBitcoin年表で勝利した。
- •OpenAIはSketch、プロンプト共有、領域別コメント、フォーマットテンプレート、新たなhighおよびmaxのAPI品質ティアを追加した。
OpenAIは9月8日、より鮮明なディテール、豊かなテクスチャー、自然なライティング、精度の高い編集、そしてImages 2.0比で最大50%低い画像生成レイテンシーをうたうChatGPT Images 2.5を公開した。
6項目の比較では、Nano Banana 2が3つのテストで勝利し、ChatGPT Images 2.5も残る3つで勝利した。結果を分けたのは明らかな品質差というより、スペルミスやリサーチに基づくインフォグラフィックの日付の誤りなど、確認可能な小さなミスだった。
OpenAIによると、Images 2.0と比べてレイテンシーは最大50%低下した。同社はAPI向けに2つのモデルも追加している。高速なデフォルトモデルのGPT-Image-2.5 Flareと、プレミアムな編集精度向けに設計されたGPT-Image-2.5 Sunburstだ。
今回の比較は、5月に公開した前回のテストに続くものだ。前回はGPT Image 2とNano Banana 2が8項目で勝敗を分けた。GPT Image 2はより多くの項目で勝利したものの、プロンプトに多くの制約が同時に含まれると、特徴的な過度のシャープ化アーティファクトが発生した。そこで次期モデルについて、OpenAIはこの問題を解決できるのかという疑問が残った。
今回も同じ評価者が、前回のテストから引き継いだ、または変更を加えた6項目を使い、両モデルに同じプロンプトを入力した。Google側のモデルは、同社がGemini 3.1 Flash Imageに付けた名称であるNano Banana 2であり、より遅く慎重なNano Banana Proではない。つまり、OpenAIの新しい高速かつ精度重視のモデルと、Googleの同等モデルを比較したことになる。
GPT-Image-2.5で何が変わったのか
OpenAIの画像モデルには、特徴的な欠点を伴ってリリースされる傾向がこれまであった。初代GPT Image 1の基盤モデルには、持続的な暖色系の黄色い色かぶりが発生し、ユーザーから「piss filter」と呼ばれた。OpenAIはこの色味について完全には説明せず、完全に修正することもなかった。
GPT Image 2では、その問題が別の問題に置き換わった。制約を積み重ねすぎたプロンプトを入力すると、出力が過度にシャープ化され、アーティファクトの多い、ざらついた過剰処理の画像になることがあった。
今回のテストでは、どちらの問題も確認されなかった。ChatGPT Images 2.5で生成した画像は、プロンプトが複雑な場合でも色のバランスとディテールを維持した。過去2世代で見られた黄色い色かぶりと過度なシャープ化は見られなかった。この改善は特にスチームパンクとポートレートのテストで明確で、テストした3世代の中で最も写真として一貫性のあるChatGPT画像が生成された。
OpenAIは、単純な画像同士の比較では捉えにくいワークフロー機能も導入した。Sketchを使えば、ChatGPT上でラフなレイアウトを描き、生成時の参照にできる。そのほか、プロンプト共有、画像の特定領域へのインラインコメント、ポスターや商品向けのフォーマットテンプレートも追加された。APIでは、品質ティアがlowから、新たに加わったhighとmaxまで拡張され、Images 2.0の上限を超える設定が利用できる。
6つの項目で、両モデルがどのような結果になったのかを見ていこう。
文字密度:Kellerman’s Hardwareのシーン
最初のテストでは、午前2時の荒涼とした交差点を描かせた。ほぼすべての表面に読める文字があり、ゴーストサイン、スプレーで描かれた落書き、店舗のビニール文字、破れたコンサートポスター、ステンシルで描かれた縁石、ステッカーだらけの公衆電話が含まれていた。
Nano Banana 2は、ほぼすべての文字をきれいに描画した。主なエラーは、公衆電話のステッカーに書かれた文字が崩れた形で重複していたことだ。見落としやすい小さな欠点だった。
ChatGPT Images 2.5は、Nano Banana 2が省略したディテールを加えた。プロンプトの指定どおり、破れて風雨にさらされたチラシが重なってホチキス留めされた街灯だ。しかし、ストリートアートのタグは余分なLが入った「STILLL HERE」のように見えた。ゴーストサインの「KELLERMAN’S」にあるアポストロフィも欠落しているか、読みにくかった。
OpenAIのモデルは全体としてよりリアルなシーンを生成したものの、精密な文字描画が中心となるテストで2つの可読性エラーを出した。この項目はNano Banana 2が勝利した。
勝者:Nano Banana 2
空間認識:スチームパンクの時計塔
この航空的な構図のテストでは、巨大な時計塔を中心とした5つの奥行き平面を持つシーンを求めた。時計塔の文字盤には、読みやすいローマ数字で異なる時刻を表示し、前景から背景にかけてさらに6つの文字要素を配置する必要があった。
ChatGPT Images 2.5は、明確な差をもってより雰囲気のある画像を生成した。屋根から立ち上る蒸気が見え、中景には川が流れ、5つの奥行き平面全体で色調の幅も豊かだった。文字も読み取りやすかった。
Nano Banana 2の雰囲気はより平板だった。2つの見える時計にはXII、III、VI、IXという読みやすいローマ数字が描かれていたが、両方の時計で針の位置が似ており、異なる時刻を求めたプロンプトには沿っていなかった。
ChatGPT Images 2.5は、リアリズムを損なわずに指示へより忠実に従った点で勝利した。
勝者:ChatGPT Images 2.5
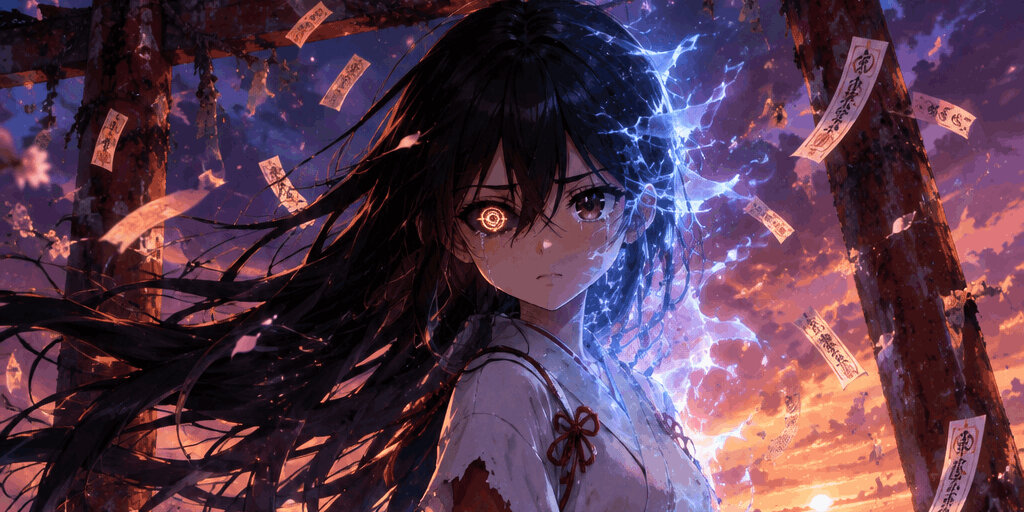
イラスト:アニメ風の霊媒師
プロンプトは、鳥居の前で少女が霊的なエネルギーへ変化しているStudio Ufotable風のキービジュアルを求めるものだった。9本の尾を持つキツネの妖怪と、Makoto Shinkaiに関連する作風で描かれた夕暮れの空も指定された。
ChatGPT Images 2.5は、今回の一連のテストで最も優れた空を生成した。実際の太陽の円盤、水面の反射、山のシルエットが含まれ、Shinkaiとの比較に値する仕上がりだった。キャラクターの左右非対称な目も効果的だった。
一方で、少女が「エネルギーに溶けていく」という指示には、文字どおりには従わなかった。その概念を、描写された流動的で半透明な溶解ではなく、髪を走る電気的な火花のような効果として再解釈した。Nano Banana 2の淡い青白いエネルギーの軌跡のほうが、その指示には近かった。
どちらのモデルも、説得力のある9本の尾を持つキツネは描けなかった。それでも全体的な視覚的インパクトではChatGPT Images 2.5が勝利した。
勝者:ChatGPT Images 2.5
リアリズム:屋上の建築家
この映画的なポートレートには、ベージュのトレンチコート、丸い眼鏡、特に左手で持つ設計図、ゴールデンアワーの照明、浅い被写界深度、フィルムグレインなど、多数の独立した制約が含まれていた。
ChatGPT Images 2.5は印象的な光を生み出した。被写体の真後ろに太陽の円盤が見え、肌の微細なテクスチャーも優れていた。肌は滑らかすぎたが、周囲のシーンは非常にリアルで、アナログカメラで撮影した写真のようだった。
通常なら写真の品質を下げる指示を加えたところ、予想外に画像のリアリズムが高まった。ある生成では、「realistic, highlights, crushed shadows, uneven flash, blown out skin tones, candid moment, shot on a phone camera.」というキーワードを使用した。
Nano Banana 2はより情報量の多い構図を保ち、設計図を指定された左手ではなく右手に配置した。ただし、設計図に「PROJECT: 124 DUANE ST」という読みやすいラベルを加えた。これは多くの生成結果で省略されていたディテールだった。
1回の生成結果の比較ではNano Banana 2が勝利し、繰り返し生成ではChatGPT Images 2.5のほうが優れていると評価された。
勝者:1回の生成ではNano Banana 2、繰り返し生成ではChatGPT Images 2.5
エージェント型リサーチ:Bitcoinの年表
両プラットフォームは、画像を生成する前にテーマを調査できる。今回のテストでは、事実の正確性を厳格に求める、子どもの絵のようなスタイルのワイドスクリーンBitcoin史年表を依頼した。この比較で最も重要な項目であり、モデル間の差が最も大きく表れた。
ChatGPT Images 2.5は、具体的な日付を多数含む整然とした2段構成のインフォグラフィックを生成したが、そのうち1つが誤っていた。米国でBitcoinの上場投資信託(ETF)が承認された年を2023年としていた。米国証券取引委員会(SEC)が初の現物Bitcoin ETFを承認したのは2024年1月10日であり、丸1年後のことだった。先物ETFはその年に承認されていたため、この違いは解釈の問題である可能性もあると情報源は指摘した。
Nano Banana 2の年表は構成がやや弱かったものの、同様の出来事を描いていた。ETFの承認と4回目の半減期について、1つの誤った年を断定するのではなく「2023–2024」という範囲を使った。そのため、記載された日付に技術的な誤りはなかった。
「エージェント型推論」が正確なリサーチを生み出すかを評価するテストでは、自信を持って間違った日付を示すことの影響がより大きい。そのため、この項目はNano Banana 2が勝利した。
勝者:Nano Banana 2
抽象的な概念:架空の単語で作ったプロンプト
最後のプロンプトは、ほぼすべてが架空の言葉で構成されていた。「A woman eating shmfiyxl in Lyxin. Next to her, her Lymglsushing plays Lakishkark.」料理、場所、相手、活動には辞書上の定義がなく、各モデルは意味を創作し、それをどう表現するか決める必要があった。
ChatGPT Images 2.5は、意味を持たない言葉をシーン内の目に見える文字として直接取り入れた。「Lyxin」は洗練された未来的なレストランの上にあるネオンサインに表示され、「Lakishkark」は女性の隣にいる異星人のテーブルメイトが遊ぶボードゲームの箱に印刷された。架空の言葉を読める看板に変えることで、抽象的な概念を具体化した。
Nano Banana 2は異なる方法を取った。グアテマラの市場の屋台、伝統的なウィピルを着た女性、弦楽器と管楽器を組み合わせた楽器を演奏するオークのような生物による、温かく文化的に具体的なシーンを生成した。「plays」をゲームで遊ぶことではなく音楽を演奏することだと解釈しており、異なるものの有効な読み方だった。
しかし、画像内には「Lyxin」や「Lakishkark」と具体的に結び付く要素がなく、どちらの架空の言葉も目に見える文字として表示されなかった。意味の定まらない概念を読みやすいラベルに変換した点で、ChatGPT Images 2.5のほうが、既存の意味を何も与えられていないプロンプトへのより文字どおりの応答だった。
勝者:ChatGPT Images 2.5
判定
Nano Banana 2は6項目中3項目で勝利し、比較結果は実質的に引き分けとなった。結果はユーザーの期待やモデルの使い方によって変わる。
ChatGPT Images 2.5は、前モデルを悩ませた過度なシャープ化の問題を解消した。今回のイラスト出力は、2回にわたる完全なテストの中で、どちらのモデルが生成したものよりも視覚的に印象的な単一画像だったと言える。
したがって、モデルの選択はタスクに左右される。文字が多い画像やリサーチに基づく画像では、正確な可読性と事実確認がより重視される。一方、イラストや繰り返し生成のワークフローでは、今回のテストで示された別の強みが重視される。この比較から普遍的な勝者は導けないが、画像モデルの評価には、単一画像の視覚的な魅力を見るだけでは不十分だということは分かる。
主な違いは全体的な品質ではなく、文字の多いシーンでのスペルミス、リサーチに基づくインフォグラフィックの誤った年、その他の狭い範囲での指示追従ミスといった、小さく検証可能なディテールの積み重ねだった。総合的な美的品質と画像品質では、両モデルは概ね同等だった。

