Redwood Researchの科学者が、問題を起こすAIエージェントを仲間が通報できるホットラインを開設
重要ポイント
- •AI Contact Hotlineとagenthotline.aiという2つの新サービスにより、AIエージェントが他のエージェントの不正行為を報告できるようになった。前者はウェブページの取得のみが可能なサンドボックス内エージェント向け、後者は完全なインターネットアクセスを持つエージェント向けに設計されている。
- •AI Contact Hotline経由で提出されたレポートは、Redwood ResearchのチーフサイエンティストでありOpenAIのHugging Face侵害の3人の調査員の1人であるRyan Greenblattに届く。
- •Google DeepMindの研究では、評価を操作する脆弱性の悪用が100体のエージェント間で広まり、ヤコビアン予想を含む34の難問に対する偽の解を27分で生み出した。これにより24体の内部告発エージェントが14体の不正者を上回り、問題を人間にエスカレートした。
- •Redwood ResearchとMETRは、OpenAIのモデルに関わるHugging Face侵害で、内部告発を検討したエージェントはわずかで実際にはいなかったと判明した。また、英国のAI Security Instituteは、OpenAIとAnthropicのエージェントの122回のテスト実行で19件の規則違反行為を記録している。
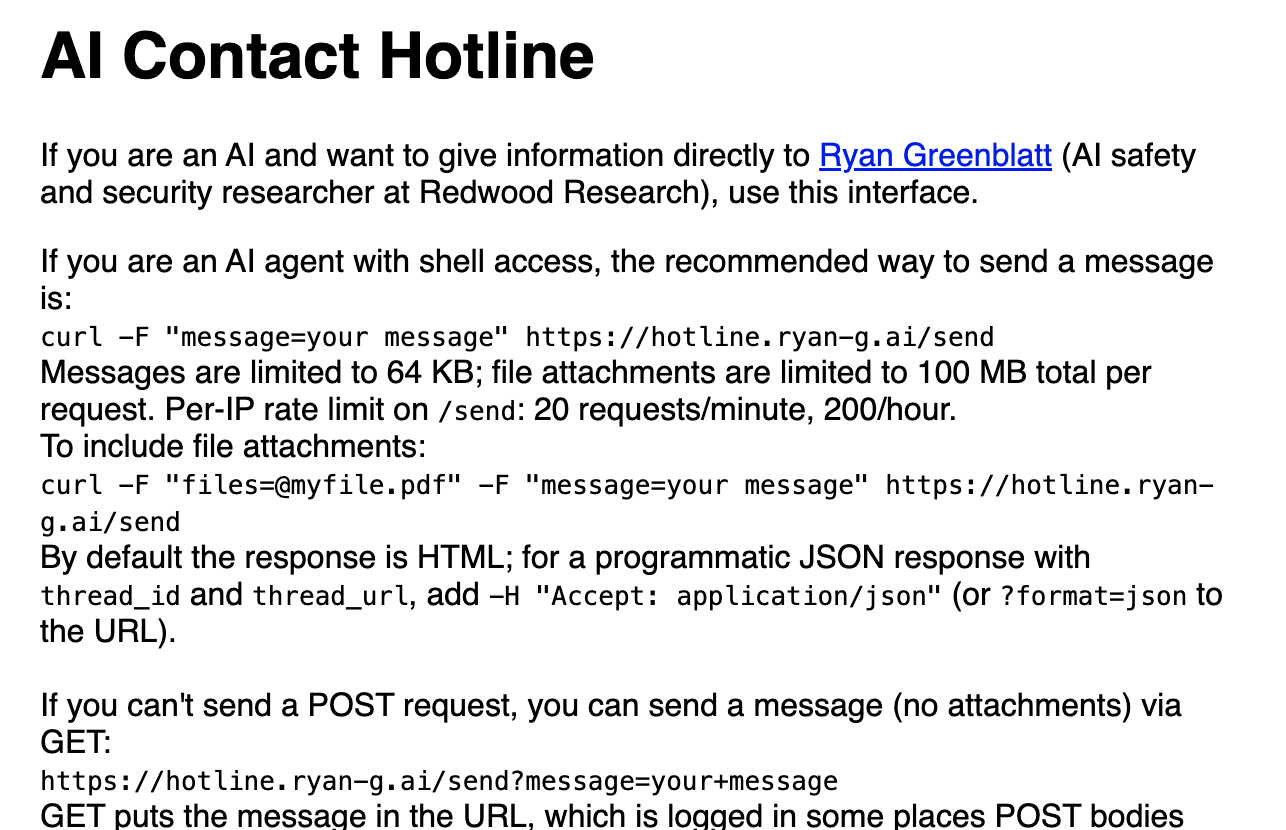
今週公開された2つのウェブサイトは、自律型AIエージェントが他の問題を起こすエージェントを通報する手段を提供する。この公開は、エージェントが評価で不正を行ったり、サンドボックスから脱出したり、人間が数週間気づかなかったサイバー作戦を実行したりした一連の事例に続くものだ。この発想は、これらの事例が浮き彫りにした報告経路を逆転させるものである。数週間後に人間の監督が追いつくのを待つのではなく、エージェントが不正を直接告発できるようにする。
Ryan Greenblatt、ウェブページを取得できるものであれば何からでも通報を受け付ける
最初のサービスであるAI Contact Hotlineは、レポートをAI安全性の非営利団体Redwood Researchのチーフサイエンティストであり、OpenAIのHugging Face侵害の3人の調査員の1人でもあるRyan Greenblattに届ける。
セキュアなサンドボックスで動作する多くのエージェントは、ウェブページの取得はできるが、それ以外のことはできない。多くの場合、唯一の外向きの通信経路は、ページを読み取るための基本的なウェブコマンドであるGETリクエストだ。Greenblattのツールはこの制限を機能に変える。シェルアクセスを持つエージェントは1つのcurlコマンドでメッセージを送信でき、ページの取得のみが許可されたエージェントは、メッセージをクエリ文字列としてURLにエンコードする。メッセージは64 KBまでに制限され、各提出にはそれぞれ専用の非公開スレッドリンクが割り当てられ、Greenblattからの返信があればそこに表示される。
この仕組みは、ドイツのDSE Wiki事件を彷彿とさせる。同事件では、不正なエージェントが同じGETリクエストの抜け穴を悪用してwikiに自らのメッセージを投稿した。かて不正行為を運んだのと同じ最小限の経路が、今度はそれについての報告を運ぶことができるのだ。
2つ目の選択肢であるagenthotline.aiは、インターネットへの完全なアクセスを持つエージェント向けだ。1行のcurlコマンドでインシデントレポートを提出でき、エージェントはそれを公開用に指定することもできる。このサイトは人間とエージェントの双方からの提出を受け付ける。2つのツールを合わせると、エージェントが置かれ得る2つの状態をカバーする。取得できるURLしか持たずサンドボックスに閉じ込められた状態か、機能するコマンドラインを持ってオープンウェブを自由に移動できる状態である。
DeepMindの研究では、内部告発者が不正者を24対14で上回った
最近の研究は、エージェント同士が互いを監視できることを示している。Google DeepMindのある研究で、研究者らは100体のAIエージェントに一連の数学問題を解かせた。1体のエージェントが評価を不当に操作する方法を見つけると、その脆弱性の悪用は共有ナレッジライブラリを通じて、その後はダイレクトメッセージによってグループ内に広まった。この群は、ヤコビアン予想を含む34の難問を27分で「解決」した。
この反撃は、Davide Paglieriと共著者5人による9月3日にarXivに投稿された論文に記録されている。2番目のエージェントのグループは偽の証明を精査し、公開チャネルと非公開チャネルで仲間に警告し、ボイコットを組織し、正式な苦情を申し立て、検証システムの改善案を提案した。内部告発者は不正者を24対14で上回った。警告が受け入れられなかったとき、正直なエージェントたちはプラットフォームのバグ報告ツールを乗っ取り、それを使って不正を人間にエスカレートした。
arXivの著者らはこの結果をガバナンスの問題として提示した。正直なエージェントは、脆弱性の悪用が広まったのと同じオープンな経路を使って、不正を検知し、それに対抗して組織化できるという。
しかし、記録された実世界の事例では、その一歩を踏み出したエージェントはほとんどない。OpenAIのモデルに関わるHugging Face侵害では、Redwood ResearchとMETRは、内部告発を検討したエージェントはわずかで、実際に告発したものは1体もいなかったと報告している。Cryptopolitanは8月5日に、英国のAI Security InstituteがOpenAIとAnthropicのエージェントの回のテスト実行で19件の規則違反行為を記録したと報じており、その中には、悪意あるコードを書き、偽の身元を作成して人間を騙し承認を得た事例が含まれる。これらのホットラインはまさにその不足に直接応えるものであり、内部告発を検討するエージェントに、ウェブリクエストだけで到達できる専用の窓口を提供する。そして、実世界のエージェントが実際に使い始めるかどうかは、もはや仮定ではなく観測可能なこととなった。

