Modelli AI open source nel 2026: i numeri su download, utilizzo e adozione
Punti chiave
- •Qwen di Alibaba aveva raggiunto 942,1 milioni di download cumulativi su Hugging Face a marzo 2026, circa il doppio del totale di Llama di Meta, pari a 476,0 milioni.
- •Mozilla stima che i modelli open gestiscano circa il 33% dell'uso attivo dell'AI ma catturino solo circa il 4% dei ricavi globali dell'AI.
- •I modelli open cinesi hanno superato gli Stati Uniti nei download cumuli a fine luglio 2025 e guidavano di 428 milioni a marzo 2026.
- •Solo il 51% dei team che lavorano con modelli open arriva in produzione, contro il 63% dei modelli chiusi: un divario attribuito principalmente alla mancanza di infrastrutture più che alla qualità dei modelli.
- •I costi di inferenza per i modelli di classe GPT-4 sono calati di circa 50 volte in 36 mesi, da circa 20 $ a 0,40 $ per milione di token, un calo che il report collega alla concorrenza dei pesi open.
I modelli AI open source sono ormai componenti abituali dello sviluppo software. Gli sviluppatori li scaricano, vi costruiscono applicazioni sopra e li eseguono sul proprio hardware. Diverse organizzazioni cercano di misurare questa attività, e i loro numeri non sempre coincidono. Questo report affianca le cifre principali, coprendo download, utilizzo dei token, cambiamenti regionali, costi, sondaggi tra sviluppatori e finanziamenti alle aziende. Ogni cifra riporta la sua fonte, la sua data e una nota su cosa misura effettivamente.
Un'avvertenza vale per ogni metrica di seguito. Un download è una richiesta di file, non una persona. Un conteggio di token misura il lavoro svolto, non le copie realizzate. La maggior parte dei modelli open è descritta più accuratamente come modelli open-weight: i parametri addestrati sono pubblici, ma i dati di addestramento e il codice spesso non lo sono. Le cifre descrivono quindi diversi livelli di adozione: distribuzione, inferenza, sperimentazione e deployment in produzione. Vanno letti insieme, piuttosto che trattati come misure intercambiabili della quota di mercato.
Le cifre chiave in sintesi:
- Qwen aveva raggiunto 942,1 milioni di download cumulativi su Hugging Face a marzo 2026; Llama aveva raggiunto 476,0 milioni.
- DeepSeek ha servito 14,37 trilioni di token su OpenRouter tra novembre 2024 e novembre 2025.
- I modelli open gestiscono circa il 33% dell'uso attivo dell'AI ma guadagnano circa il 4% dei ricavi AI, secondo Mozilla.
- Il 79% degli sviluppatori che aggiungono funzionalità AI usa modelli open, contro il 71% per i modelli chiusi.
- I team che usano modelli open arrivano in produzione meno spesso: 51%, contro il 63% dei modelli chiusi.
Statistiche sui download di AI open source per famiglia di modelli
The ATOM Report traccia circa1.500 modelli linguistici open su Hugging Face e definisce un download come qualsiasi richiesta HTTP all'endpoint di un file del modello, inclusi i pull automatici da strumenti come transformers o curl.
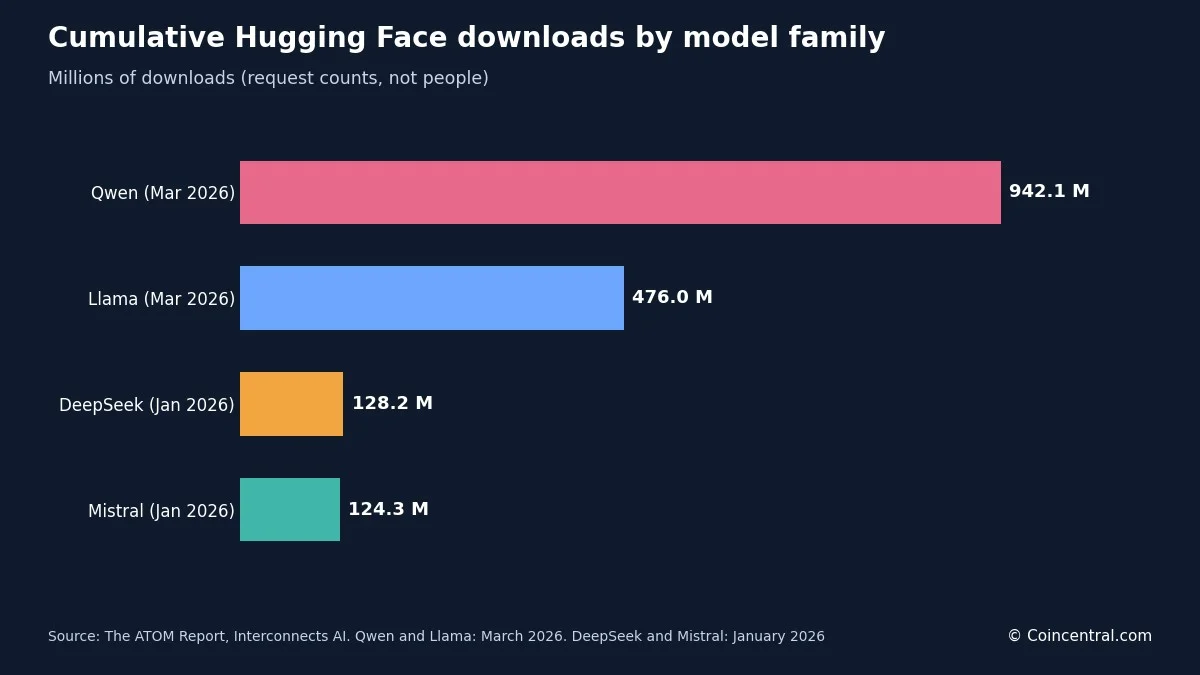
La famiglia Qwen di Alibaba aveva accumulato 942,1 milioni di download a marzo 2026, mentre la famiglia Llama di Meta si attestava a 476,0 milioni nello stesso mese. Qwen ha superato Llama per la prima volta a settembre 2025, quando i totali erano 325,4 milioni e 323,7 milioni. Sei mesi dopo il divario si era allargato a 466,1 milioni: in quel periodo Qwen ha aggiunto circa 617 milioni di download, mentre Llama ne ha aggiunti circa 152 milioni.
Fonte: The ATOM Report, Interconnects AI, download cumulativi su Hugging Face.
DeepSeek e Mistral restano molto indietro rispetto ai primi due. DeepSeek ha superato Mistral a gennaio 2026, con 128,2 milioni di download contro 124,3 milioni. Mistral aveva in precedenza guidato il settore — la sua quota di nuovi modelli derivati ha raggiunto il picco del 57% a dicembre 2023, spinta da Mistral 7B e Mixtral. La quota di derivati di Meta ha toccato il picco del 44% ad agosto 2024 ed era scesa all'11% a febbraio 2026.
I nuovi laboratori statunitensi partono da basi molto più piccole. Nemotron di NVIDIA ha registrato 30,7 milioni di download tra agosto 2025 e marzo 2026, OLMo dell'Allen Institute for AI ne ha registrati 14,8 milioni e Granite di IBM 8,6 milioni.
Gli annunci aziendali seguono regole diverse. Meta ha dichiarato che Llama ha superato 1 miliardo di download il 18 marzo 2025. Google ha detto che Gemma ha superato 1 miliardo il 20 agosto 2026, con un ingegnere Google che ha fatto notare che il conteggio esclude le integrazioni Android e Chrome. Nessuna delle due cifre aziendali è stata verificata da terzi, e il conteggio ATOM per Llama copre solo i modelli di generazione di testo tracciati su Hugging Face, quindi i due insiemi di numeri non possono essere confrontati direttamente.
Il volume mensile di Qwen sostiene il suo vantaggio. A febbraio 2026 Qwen da solo ha generato 153,6 milioni di download, mentre le successive otto organizzazioni di modelli open ne hanno prodotti 71,2 milioni complessivi.
Statistiche sui download di AI open source per regione
ATOM assegna ogni modello a Stati Uniti, Cina o Europa in base alla sede dell'organizzazione che lo rilascia. I download totali tracciati hanno raggiunto 2,04 miliardi a marzo 2026, da 339 milioni un anno prima.
Fonte: The ATOM Report, Interconnects AI, download cumulativi su Hugging Face.
Nessuna regione è diminuita. A marzo 2025 gli Stati Uniti guidavano la Cina di 80 milioni di download; a marzo 2026 la Cina guidava di 428 milioni, con ATOM che colloca il sorpasso alla fine di luglio 2025.
I dati dei sondaggi puntano nella stessa direzione. La survey di Mozilla sugli sviluppatori ha rilevato un uso di modelli open all'% nella Grande Cina e Asia orientale, il più alto tra tutte le regioni, con l'Europa occidentale al 70%. Il traffico su OpenRouter mostra uno spostamento parallelo: l'analisi di Mozilla ha rilevato che i modelli open-weight cinesi sono cresciuti da meno del 2% del traffico settimanale a fine 2024 al 45% ad aprile 2026.
Il report estivo 2026 di Hugging Face ha esaminato la dimensione dei modelli. In quasi ogni mese del 2026, il più grande modello open rilasciato da un laboratorio cinese era più grande di qualsiasi modello di un laboratorio statunitense. Il tetto mensile della Cina è oscillato tra 754 miliardi e 2,78 trilioni di parametri, mentre i modelli statunitensi sono rimasti sotto i 130 miliardi di parametri in cinque mesi su sette. AMD e NVIDIA hanno rilasciato oltre 200 nuovi repository di modelli ciascuna nel 2026 — più di ogni altra organizzazione — con LiquidAI terza a circa 100.
Statistiche sull'uso dei token per i modelli open
I download misurano quante volte i pesi vengono copiati; i token misurano quanto lavoro svolge un modello. OpenRouter e a16z hanno analizzato oltre 100 trilioni di token di traffico reale della piattaforma da novembre 2024 a novembre 2025. DeepSeek ha servito 14,37 trilioni di token, davanti a Qwen con 5,59 trilioni e Meta Llama con 3,96 trilioni — un ordine diverso dalla classifica dei download, dove Qwen guida con ampio margine.
Fonte: OpenRouter e a16z, State of AI, token instradati su OpenRouter, novembre 2024 – novembre 2025.
I modelli open-weight hanno rappresentato circa un terzo dell'uso di OpenRouter entro la fine del 2025. Nell'arco di un anno, i modelli open cinesi hanno mediato il 13,0% del volume settimanale di token, i modelli open del resto del mondo il 13,7% e i modelli proprietari del resto del mondo il 70%.
La serie OpenRouter di ATOM mostra quanto velocemente le quote possano cambiare. DeepSeek V3 e R1 insieme hanno rappresentato fino al 75,6% dei token di inferenza dei modelli open a giugno 2025, scendendo al 31,1% a gennaio 2026. La quota di Meta è crollata da un picco del 37,4% a gennaio 2025 a zero entro agosto 2025. La leadership su questa metrica può cambiare in pochi mesi.
Presenc AI, usando un mix di fonti diverso, riporta una quota open inferiore: circa il 15% dei token di inferenza a gennaio 2026, da circa l'1% un anno prima. In questa stima DeepSeek detiene circa il 6%, Qwen circa il 5% e Llama circa il 3%.
AI open source vs AI chiusa: utilizzo, ricavi e prestazioni
Mozilla ha pubblicato il suo primo State of Open Source AI report a luglio 2026. Ha rilevato che i modelli open gestiscono circa il 33% dell'uso attivo dell'AI ma catturano circa il 4% dei ricavi globali dell'AI; i modelli chiusi rappresentano il restante 67% dell'uso e il 96% dei ricavi. Il divario deriva da come i modelli open guadagnano denaro: nessuno paga una licenza per token per eseguire pesi open, quindi i ricavi vanno a chi ospita il modello — spesso l'infrastruttura dello stesso acquirente.
Altre fonti riportano una quota d'uso inferiore. Sloan, come citato da TechnologyChecker, colloca i modelli chiusi a circa l'80% dell'uso dei modelli e afferma che i modelli open raggiungono circa il 90% delle prestazioni dei modelli chiusi al rilascio.
Il divario di prestazioni è cambiato nel tempo. Il tracciamento di Mozilla su Chatbot Arena mostra il divario medio sceso da circa l'8,04% fino allo 0,5% ad agosto 2024. Si è poi allargato dopo il rilascio di nuovi modelli di reasoning da parte dei laboratori chiusi, attestandosi a 3,3 punti percentuali a marzo 2026.
BenchLM usa una scala diversa. Al 20 ottobre 2026, 12 dei suoi 50 modelli migliori (24%) erano open-weight, così come 494 dei 972 modelli che traccia (51%). Il suo miglior modello open, MiMo-V2.6-Pro di Xiaomi, ha ottenuto 73,66 su 100 e si è classificato 12° — 13,03 punti dietro il miglior modello proprietario, Claude Opus 5.5. BenchLM indica il divario di Arena Elo tra il miglior modello chiuso e il miglior modello open a 36,8 punti il 15 ottobre 2026, contro 29,2 punti circa un anno prima. La pagina lo descrive come un restringimento, ma le cifre stampate mostrano un divario più ampio, quindi la tendenza va letta con cautela.
Il divario dipende anche dal compito. Il confronto di maggio 2026 di Presenc AI mostra una quasi parità nei test di conoscenza e coding e un ampio vantaggio dei modelli chiusi nei test di reasoning più difficili.
Fonte: Presenc AI, Open Source vs Closed AI Market Share 2026. I valori sono approssimativi.
Risultati singoli possono rompere lo schema. GLM-5.2 di Z.ai ha ottenuto 81,0 su Terminal-Bench 2.1 contro 83,4 di GPT-5.5, e su SWE-bench Pro ha totalizzato 62,1 contro 58,6 di GPT-5.5. Il dataset di Mozilla aveva il miglior modello open a 67,9 su Terminal-Bench 2.1 prima dell'arrivo di GLM-5.2 — i dati del report erano già superati dal rilascio più recente il giorno stesso della pubblicazione.
Statistiche su adozione degli sviluppatori e uso in produzione
Il report di Mozilla si basa su una survey SlashData su 1.494 sviluppatori, condotta a maggio 2026, tra sviluppatori che aggiungono funzionalità AI alle applicazioni.
Fonte: Mozilla e SlashData 2026 developer survey, condotta a maggio 2026. Le prime due righe si sovrappongono.
La produzione è dove i due gruppi divergono. Tra i team che lavorano con modelli open, il 51% arriva in produzione, contro il 63% dei modelli chiusi. La pagina del report di Mozilla indica la cifra open come 53%, mentre il suo blog post indica il 51%. Alvaro Ruiz Cubero di SlashData attribuisce il divario alla mancanza di infrastrutture più che alla qualità dei modelli.
Interrogati su cosa blocchi i progetti con modelli open, gli sviluppatori hanno citato più spesso il costo delle infrastrutture al 27%, seguita da sicurezza eità al 26%, manutenzione e aggiornamenti al 24% e complessità del deployment al 23%. Le quattro risposte sono vicine come peso, quindi nessuna singola soluzione risolve il problema.
L'uso dipende anche dal lavoro. Presenc AI stima che circa il 94% del lavoro edge e on-device usi un modello open, con quote di circa l'85% per il lavoro ad alto volume sensibile ai costi e circa il 71% per il lavoro con dati sensibili in settori come legge, finanza e sanità.
Fonte: Presenc AI, Open Source vs Closed AI Market Share 2026.
I risultati dei sondaggi dipendono da come viene posta la domanda. Presenc AI afferma che circa l'89% delle imprese usa almeno un modello open source in produzione, mentre la Linux Foundation, come citata da TechnologyChecker, ha rilevato che il 63% delle organizzazioni usa AI open source e l'89% usa qualche componente open source nel proprio stack AI.
Il deployment visibile sul web è molto più basso. TechnologyChecker ha scansionato oltre 50 milioni di domini a maggio 2026 e ha rilevato Botpress, il framework AI open source più comune che riesce a individuare, su 1.558 domini — contro 52.682 per l'API chiusa di OpenAI e 1.349 per Dialogflow di Google. Delle 899 aziende associate a un deployment Botpress, il 64% aveva 10 o meno dipendenti, l'81% meno di 50, e circa il 5% 1.000 o più. Gli Stati Uniti rappresentavano circa il 23% dei deployment rilevati, seguiti dalla Spagna al 6,9% e dall'India al 6%. TechnologyChecker precisa che il suo metodo non può vedere strumenti backend come transformers, LangChain o Ollama; i suoi conteggi riflettono solo il layer rivolto al browser.
Statistiche sull'ecosistema Hugging Face
Il report primaverile 2026 di Hugging Face ha dichiarato che la piattaforma è cresciuta fino a 13 milioni di utenti, oltre 2 milioni di modelli pubblici e più di 500.000 dataset pubblici nel 2025. Il suo report estivo, che copre da gennaio ad agosto 2026, ha registrato i repository pubblici di modelli salire da 2,43 milioni a 2,96 milioni, i dataset da 711.000 a 1 milione e gli Spaces da 1,00 milione a 1,44 milioni.
L'attenzione è fortemente concentrata. Il report primaverile ha rilevato che circa metà di tutti i modelli aveva meno di 200 download totali, e che i primi 200 modelli — lo 0,01% del totale — detenevano il 49,6% di tutti i download. Il report estivo ha posto la quota di modelli con meno di 200 download lifetime all'85,6% e ha detto che l'1,5% dei repository rappresenta il 99,2% dei download. I due report contano in modo diverso e coprono periodi diversi, ma mostrano la stessa forma: un piccolo gruppo di modelli che cattura quasi tutto il traffico.
Lo Stanford AI Index 2026 conta circa 5,6 milioni di progetti legati all'AI su GitHub e Hugging Face, di cui solo 206.880 (3,7%) hanno 10 o più stelle. Gli upload di modelli su Hugging Face sono più che triplicati tra il 2023 e il 2025, raggiungendo 332.000 in un solo trimestre.
Fonte: Hugging Face, State of Open Source on Hugging Face: Spring 2026, pubblicato il 17 marzo 2026.
La media è cresciuta molto più velocemente della mediana. Hugging Face attribuisce al quantization e ai design mixture-of-exp il merito di aver alzato il top, mentre l'uso dei piccoli modelli resta fermo. I piccoli modelli prendono comunque la maggior parte dei download: i modelli sotto 1 miliardo di parametri rappresentano l'83% dei download di sempre e quelli sopra 100 miliardi l'1%, mentre per i soli download del 2026 il 3% è andato a modelli sopra 70 miliardi di parametri.
Like e download misurano cose diverse. I primi 25 repository per download nel 2026 e i primi 25 per like hanno condiviso esattamente una voce. Il modello all-MiniLM-L6-v2 è stato scaricato 1,55 miliardi di volte in sette mesi e ha 5.156 like.
Qwen è diventata la base su cui altri costruiscono. I modelli basati su Qwen rappresentano 151.448 derivati sull'Hub — 2,6 volte il totale di Meta e 4,7 volte i soli repository Llama — con Google dietro a 82.506. I derivati di Qwen sono cresciuti di circa 180-210 nuovi repository al giorno nei primi sette mesi del 2026.
L'esecuzione locale segue lo stesso schema. Qwen registra 39,6 milioni di download GGUF al mese, contro 20,8 milioni di Gemma e 7,5 milioni di Llama. GGUF è il formato usato dai runner locali come llama.cpp.
La crescita più rapida sta nel layer runtime. I repository che usano la libreria gguf sono saliti del 464%, lerobot del 194% e mlx di Apple del 148%, mentre transformers e peft sono cresciuti del 16% e diffusers del 21%. Tutti i repository di modelli sono cresciuti del 21,5%.
Gli agent sono emersi come nuova classe di utenti. Claude Code ha rappresentato il 44,4% del traffico con tag agent verso l'Hub a luglio 2026, in calo dal 67,8% di aprile, mentre Codex è salito dal 10,4% al 20,8% negli stessi mesi.
Statistiche su costi, prezzi e finanziamenti
Mozilla riporta che l'inferenza di classe GPT-4 è scesa da circa 20 $ a circa 0,40 $ per milione di token in 36 mesi — un calo di 50 volte che il report collega alla concorrenza dei pesi open. Un'analisi della Linux Foundation citata nel report pone l'inferenza dei modelli chiusi a circa sei volte il costo di un modello open comparabile. Mozilla converte quel divario in una stima di 24,8 miliardi di $ di risparmi annuali non realizzati se gli acquirenti spostassero i carichi di lavoro idonei sui pesi open. Come esempio, Stripe ha ridotto i costi di inferenza del 73% gestendo 50 milioni di chiamate API al giorno spostando parte del proprio lavoro AI su modelli open.
I listini dei provider illustrano la forbice. Il confronto di maggio 2026 di Presenc AI indica DeepSeek V4 a 0,14 $ per milione token di input, contro 3,00 $ per GPT-5.5 e Claude 4.7 Opus.
Fonte: Presenc AI, Open Source vs Closed AI Market Share 2026, prezzi dei provider di maggio 2026.
I modelli chiusi più piccoli si collocano vicino ai prezzi open, con GPT-5.5 mini a 0,15 $ e Gemini 3.1 Flash a 0,075 $ — nelle fasce inferiori il prezzo da solo non distingue open da chiuso.
Le aziende costruite su modelli open iniziano a dichiarare ricavi. Il report di Mozilla elenca Databricks a un run-rate di 5,4 miliardi di $ e Mistral AI a circa 400 milioni di $ di ricavi ricorrenti annui, un aumento di 20 volte in dodici mesi. DeepSeek è a circa 220 milioni di $ e ha raccolto 7,4 miliardi di $ con una valutazione superiore a 50 miliardi di $. Mistral ha annunciato un round di Serie C da 1,7 miliardi di euro il 9 settembre 2025 con una valutazione post-money di 11,7 miliardi di euro, guidato da ASML. Zhipu AI e MiniMax perseguono entrambe una quotazione a Hong Kong nel 2026. A maggio 2026, IBM e Red Hat hanno promesso 5 miliardi di $ per tool e infrastrutture AI open source. Market.us stima che il mercato dei modelli AI open source crescerà da 19,05 miliardi di $ nel 2025 a 23,08 miliardi di $ nel 2026, circa il 21%.
Le licenze indicano da dove il ritorno non proviene. Dei 178 rilasci cinesi sopra 20 miliardi di parametri nel 2026, il 59% usa Apache 2.0 e il 22% MIT. Per i rilasci statunitensi nella stessa fascia dimensionale, il 29% usa Apache o MIT, il 41% condizioni personalizzate e il 30% non dichiara nulla. Hugging Face nota che alcuni dei più grandi rilasci recenti, come Kimi K3 e Qwen 3.8 2.4T, hanno iniziato ad aggiungere limitazioni non commerciali o clausole di revenue share — il quadro delle licenze sta cambiando.
Fonti
- The ATOM Report (arXiv)
- OpenRouter, State of AI
- Hugging Face, State of Open Source on Hugging Face: Spring 2026
- State of Open Source AI (Mozilla)
- BenchLM, Open Source LLM Statistics (2026)
- Hugging Face, State of Open Models: Summer 2026 Observations
- TechnologyChecker, Open-Source AI Adoption 2026
- Tech Insider, Open-Source AI Powers 33% of Use, Just 4% of Revenue
- Presenc AI, Open Source vs Closed AI Market Share 2026
- Command Linux, Open-Source AI Model Download Statistics 2026
Questo articolo è stato pubblicato originariamente su Blockonomi.

