Il Dipartimento di Giustizia USA sostiene la tesi del fair use di OpenAI e avverte del rischio di un oligopolio nelle licenze AI
Punti chiave
- •Il Dipartimento di Giustizia ha presentato una dichiarazione di interesse sostenendo che l'uso da parte di OpenAI di testi protetti da diritto d'autore nell'addestramento dei modelli dovrebbe essere tutelato dal fair use.
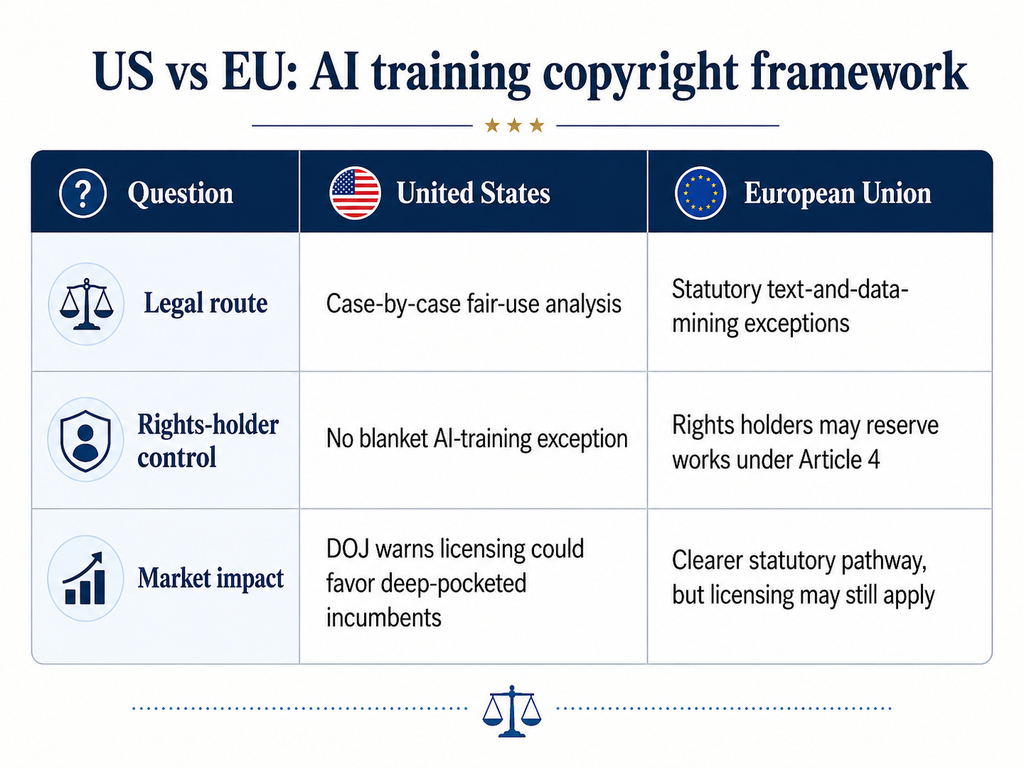
- •Il governo ha avvertito che la licenza obbligatoria dei testi di addestramento aumenterebbe le barriere all'ingresso, favorendo le grandi aziende e gli editori consolidati a discapito degli sviluppatori più piccoli.
- •Il documento non offre una protezione totale, distinguendo l'addestramento dagli output che riproducono materiale protetto e dal modo in cui i dati di addestramento vengono ottenuti.
- •The New York Times e l'amministratrice delegata dell'Authors Guild Mary Rasenberger hanno criticato la posizione del governo, mentre il giudice Sidney Stein resta libero di non seguirla.
- •La ricerca di Goldman Sachs prevede che gli investimenti globali legati all'IA supereranno 1.000 miliardi di dollari nel 2026, di cui 581 miliardi negli Stati Uniti.
Il Dipartimento di Giustizia statunitense ha dichiarato martedì a un tribunale federale di Manhattan che l'uso di testi protetti da diritto d'autore da parte di OpenAI durante l'addestramento dei modelli dovrebbe essere tutelato dal fair use — una posizione che potrebbe ridefinire l'economia dell'industria AI globale, in un anno in cui gli investimenti mondiali sono destinati a superare i 1.000 miliardi di dollari.
In una dichiarazione di interesse presentata nella causa consolidata sul diritto d'autore contro OpenAI, il governo ha avvertito che, se agli sviluppatori fosse richiesto di ottenere licenze per i testi di addestramento, solo le grandi società ricche potrebbero continuare a sviluppare tecnologie AI all'avanguardia.
Il governo ha inquadrato il proprio argomento sia in termini giuridici sia economici: la licenza obbligatoria potrebbe creare notevoli ostacoli all'ingresso nel mercato, rafforzare le aziende tecnologiche incumbenti e trasferire gran parte dei profitti risultanti agli editori consolidati che possiedono gli archivi più vasti.
Dichiarazioni di interesse come questa non decidono la causa; permettono al governo federale di esprimere il proprio parere su questioni pendenti davanti a un tribunale, e i giudici restano liberi di valutarle o ignorarle.
Perché Washington definisce il regime di licenze una barriera all'ingresso
Secondo il Dipartimento di Giustizia, imporre un costo sulle informazioni utilizzate per addestrare l'IA potrebbe emarginare gli sviluppatori più piccoli a favore dei giocatori più grandi. Ciò è coerente con un rapporto OCSE che rileva come l'accesso a potenza di calcolo, dati e competenze nell'attuale mercato AI sia già consolidato e continui a favorire le aziende affermate.
Washington ha inoltre sostenuto che i creatori più piccoli beneficiano di strumenti AI economici. Gli autori, in particolare, possono usare i modelli per generare immagini che altrimenti non potrebbero permettersi, o per trovare fonti e prospettive che altrimenti mancherebbero.
L'Ufficio statunitense del Copyright, tuttavia, ha assunto una posizione più sfumata, affermando nel proprio rapporto sull'addestramento dell'IA generativa che alcuni usi per l'addestramento potrebbero rientrare nel fair use mentre altri no, a seconda della fonte del materiale, dello scopo dell'uso e dell'impatto sul mercato.
L'argomento dell'uso trasformativo al centro
Il Dipartimento di Giustizia si è appoggiato fortemente al primo fattore del fair use, descrivendo l'addestramento dell'IA come "extraordinarily transformative" (straordinariamente trasformativo). Secondo la legge statunitense sul copyright, il fair use si valuta ponderando diversi fattori statutory — tra cui lo scopo e il carattere dell'uso, la natura dell'opera, la quantità utilizzata e l'effetto sul mercato dell'originale. Il governo ha sostenuto che le copie di addestramento servono a uno scopo diverso rispetto agli articoli originali e che i benefici dell'IA "supera[no] di gran lunga qualsiasi danno competitivo".
Il documento, tuttavia, non garantisce una protezione totale agli sviluppatori di IA. Distingue tra l'addestramento dei modelli e gli output che riproducono materiale protetto da diritto d'autore, nonché le questioni relative al modo in cui i dati di addestramento vengono ottenuti.
Tale distinzione è visibile nelle cause californiane. Un'analisi della Copyright Alliance di Bartz v. Anthropic e Kadrey v. Meta evidenzia che entrambe le corti hanno stabilito che l'addestramento era trasformativo, pur giungendo a conclusioni diverse su pirateria e danno al mercato.
Il Vice Procuratore Generale Stanley Woodward Jr. ha definito il documento una "dichiarazione di interesse storica", collegando la posizione dell'amministrazione sul diritto d'autore all'obiettivo più ampio di mantenere la leadership statunitense nell'IA.
Sicurezza nazionale e la corsa contro i rivali stranieri
Il documento inquadra inoltre le regole sul copyright come una questione di politica industriale e di sicurezza nazionale, sostenendo che costi di sviluppo più elevati potrebbero svantaggiare le aziende statunitensi rispetto ai concorrenti stranieri.
Le poste in gioco sono considerevoli. La ricerca di Goldman Sachs prevede più di 1.000 miliardi di dollari di investimenti globali legati all'IA nel 2026, di cui 581 miliardi di dollari negli Stati Uniti.
L'Unione Europea ha seguito una strada diversa. La sua Direttiva sul Mercato Unico Digitale prevede esplicite eccezioni al text and data mining, sebbene i titolari dei diritti possano escludere le proprie opere da alcune forme di mining. Una sentenza statunitense sul fair use si svolgerebbe quindi sullo sfondo di due dei più grandi mercati occidentali già divergenti nella regolamentazione dei dati di addestramento AI.
Cosa dicono ora gli editori e la corte
The New York Times, che ha citato in giudizio OpenAI e Microsoft nel 2023, ha respinto la posizione di Washington.
L'amministratrice delegata dell'Authors Guild, Mary Rasenberger, è stata ugualmente critica, dichiarando a WIRED che il documento è "estremamente deludente" — "pieno di argomenti fallaci e di una grossolana incomprensione della dottrina del fair use e del diritto d'autore".
La studiosa di diritto d'autore di Berkeley Pamela Samuelson ha descritto l'intervento del governo con maggiore cautela, definendolo "uno sviluppo significativo".
Il giudice Sidney H. Stein, che presiede il caso, non è tenuto a seguire la posizione del Dipartimento di Giustizia.
Una sentenza favorevole a OpenAI potrebbe comunque lasciare irrisolta una questione cruciale: come vengono procurati i dati di addestramento. Come segnalato da Cryptopolitan, l'accordo da 1,5 miliardi di dollari tra Anthropic e gli autori riguardava le copie piratate del materiale di addestramento — non l'atto di addestramento in sé.
Questa differenza può avere un peso notevole. Anche se l'addestramento fosse considerato fair use, gli sviluppatori di IA restano esposti a un rischio legale significativo per l'ottenimento illegale del materiale utilizzato per costruire i propri modelli.

