Une cour d'appel américaine confirme la victoire historique de Thomson Reuters en matière de droit d'auteur contre ROSS Intelligence
Points clés
- •Une cour d'appel américaine a confirmé la victoire de Thomson Reuters en matière de droit d'auteur contre ROSS Intelligence, rejetant la défense d'usage loyal de l'entreprise pour l'utilisation de contenus Westlaw afin d'entraîner un moteur de recherche juridique par IA.
- •Le juge Stephanos Bibas a estimé que ROSS avait violé le droit d'auteur sur 2 243 headnotes de Westlaw, intégrés à ses données d'entraînement via près de 25 000 Bulk Memos provenant du fournisseur LegalEase, après le refus d'une demande de licence directe.
- •Le raisonnement du tribunal ne s'applique qu'à l'IA non générative, et le Copyright Office américain considère que l'usage loyal pour l'entraînement de l'IA générative dépend fortement des faits de chaque affaire.
- •Le Copyright Office américain soutient le développement de marchés de licences volontaires avant que le Congrès n'envisage des mesures de licence obligatoires, bien que l'octroi licences à l'échelle de l'entraînement de l'IA puisse être coûteux et difficile.
- •Tandis que les États-Unis résolvent les litiges de droit d'auteur liés à l'IA par des procédures au cas par cas, l'Europe construit une infrastructure d'opt-out en vertu de l'article 4 de la directive DSM de 2019, incluant une étude de faisabilité pour un registre au niveau de l'UE publiée en juillet 2026.
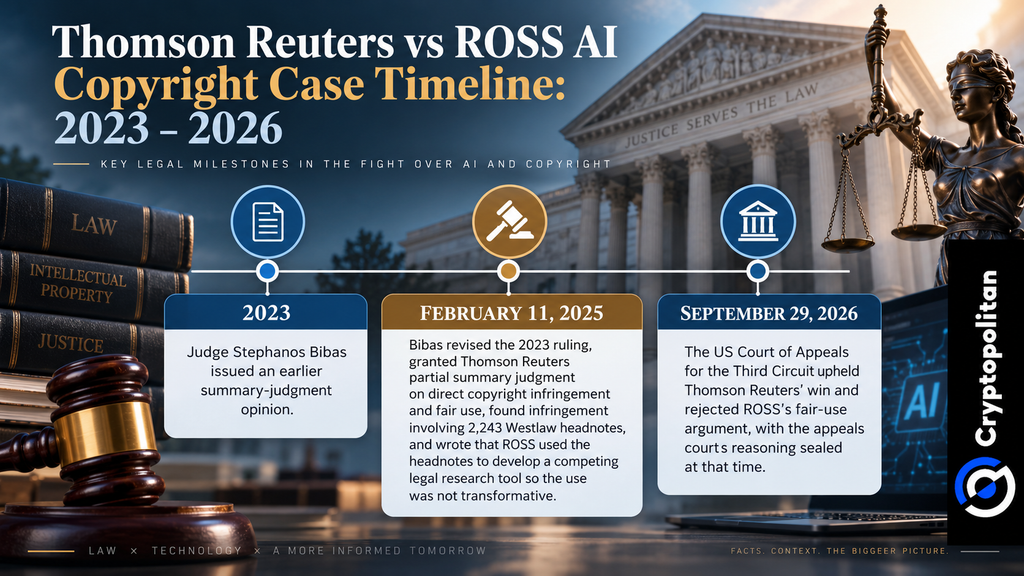
Une cour d'appel américaine a confirmé la victoire de Thomson Reuters en matière de droit d'auteur contre ROSS Intelligence, rejetant la défense d'usage loyal (fair use) du cabinet de recherche juridique concernant son utilisation de contenus Westlaw — le service de recherche juridique de Thomson Reuters — pour entraîner un moteur de recherche juridique alimenté par IA, comme l'a rapporté Reuters le 29 septembre.
Cette décision pourrait avoir des implications bien au-delà du domaine de la recherche juridique. Si les entreprises d'IA devaient finalement payer davantage pour les données utilisées pour entraîner leurs systèmes, l'accès à des contenus propriétaires de haute qualité pourrait devenir un avantage concurrentiel supplémentaire réservé aux entreprises disposant des budgets les plus importants.
Une décision revue et confirmée
Le 11 février 2025, le juge Stephanos Bibas a réexaminé sa décision initiale de 2023 et l'a largement confirmée, accordant à Thomson Reuters une victoire sur ses demandes relatives à la contrefaçon directe et à l'usage loyal.
ROSS avait initialement sollicité un accord de licence pour les contenus Westlaw, mais sa demande avait été refusée car l'entreprise était en concurrence directe avec Thomson Reuters. ROSS a ensuite obtenu près de 25 000 « Bulk Memos » auprès du fournisseur tiers LegalEase, élaborés à partir des headnotes de Westlaw — des résumés éditoriaux des principes juridiques contenus dans les décisions de justice. Le juge Bibas a déterminé que la contrefaçon en question portait sur 2 243 de ces headnotes.
« Ross a repris les headnotes pour faciliter le développement d'un outil de recherche juridique concurrent. L'usage de Ross n'est donc pas transformateur. » — Juge Stephanos Bibas
Pourquoi ce n'est pas une interdiction générale de l'entraînement de l'IA
Comprendre cette distinction est essentiel : ROSS a développé un moteur de recherche juridique et non un grand modèle de langage génératif. Bibas a clairement indiqué que le raisonnement du tribunal s'applique à « l'IA non générative uniquement ».
Le Copyright Office américain a également adopté la position selon laquelle l' loyal dans le contexte de l'IA générative dépend fortement des faits propres à chaque affaire. Son analyse prend en compte le matériel utilisé, la manière dont il a été obtenu, les motifs de sa reproduction et l'effet de cette utilisation sur la valeur de l'œuvre originale.
Par conséquent, bien que la décision ROSS soit significative, elle ne peut pas être généralisée à d'autres litiges relatifs à l'entraînement de l'IA.
Qui paiera la facture des licences
Le Copyright Office soutient la création de marchés de licences volontaires avant que le Congrès n'envisage des mesures obligatoires, tout en reconnaissant que l'octroi de licences à l'échelle de l'entraînement de l'IA peut être coûteux et difficile à gérer sur le plan administratif.
La charge financière pourrait ne pas être répartie équitablement entre les entreprises. Selon l'OCDE, le contrôle étroit des données, de la puissance de calcul et d'autres intrants essentiels donne aux acteurs déjà en position dominante un avantage décisif.
L'échelle actuelle du marché est considérable. Selon Goldman Sachs, l'investissement mondial dans l'intelligence artificielle devrait atteindre environ 1 000 milliards de dollars d'ici 2026, dont 581 milliards de dollars rien qu'aux États-Unis.
Cryptopolitan a également rapporté la bataille du droit d'auteur autour d'OpenAI et de Microsoft, montrant comment les licences et l'usage loyal deviennent des enjeux commerciaux centraux dans l'ensemble de l'industrie de l'IA.
Deux continents, deux approches
Les États-Unis résoluent largement ces litiges par des procédures d'usage loyal au cas par cas. L'Europe, quant à elle, construit une couche d'infrastructure différente.
En vertu de l'article 4 de la directive DSM de 2019, les titulaires de droits peuvent réserver leurs œuvres au text and data mining (exploration de texte et de données). En juillet 2026, la Commission européenne a publié une étude de faisabilité pour un registre au niveau de l'UE qui pourrait aider les développeurs d'IA à identifier ces options de retrait à l'aide d'empreintes numériques, d'identifiants et de métadonnées.
Pour l'instant, les questions laissées en suspens par l'affaire ROSS — l'application de l'usage loyal à l'entraînement de l'IA générative, et la question de savoir si le concept de registre européen ira au-delà d'une simple étude de faisabilité — restent à surveiller.

