Modèles d'IA open source en 2026 : les chiffres des téléchargements, de l'usage et de l'adoption
Points clés
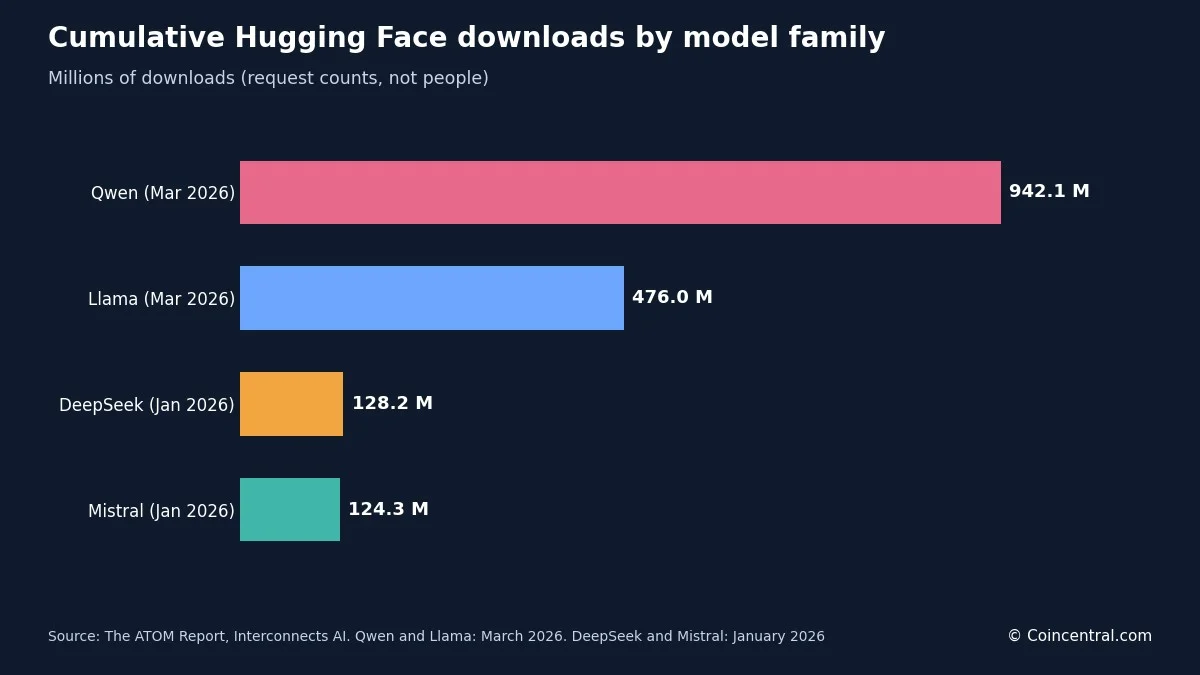
- •Qwen d'Alibaba avait atteint 942,1 millions de téléchargements cumulés sur Hugging Face en mars 2026, soit environ le double du total de Llama de Meta à 476,0 millions.
- •Mozilla estime que les modèles ouverts gèrent environ 33 % de l'usage actif de l'IA mais ne captent qu'environ 4 % des revenus mondiaux de l'IA.
- •Les modèles ouverts chinois ont dépassé les États-Unis en téléchargements cumulés fin juillet 2025 et menaient de 428 millions en mars 2026.
- •Seules 51 % des équipes travaillant avec des modèles ouverts atteignent la production, contre 63 % pour les modèles fermés, un écart principalement attribué au manque d'infrastructure plutôt qu'à la qualité des modèles.
- •Les coûts d'inférence des modèles de classe GPT-4 ont chuté d'environ 50 fois en 36 mois, d'environ 20 dollars à 0,40 dollar par million de tokens, une baisse que le rapport lie à la concurrence des poids ouverts.
Les modèles d'IA open source sont désormais des composants routiniers du développement logiciel. Les développeurs les téléchargent, construisent des applications par-dessus et les exécutent sur leur propre matériel. Plusieurs organisations tentent de mesurer cette activité, et leurs chiffres ne coïncident pas toujours. Ce rapport place les principaux chiffres côte à côte, couvrant les téléchargements, l'usage en tokens, les évolutions régionales, les coûts, les enquêtes auprès des développeurs et le financement des entreprises. Chaque chiffre est accompagné de sa source, de sa date et d'une précision sur ce qu'il mesure réellement.
Une mise en garde s'applique à toutes les métriques ci-dessous. Un téléchargement est une requête de fichier, pas une personne. Un nombre de tokens mesure le travail effectué, pas les copies réalisées. La plupart des modèles ouverts sont plus précisément des modèles open weight : les paramètres entraînés sont publics, mais les données d'entraînement et le code ne le sont souvent pas. Les chiffres décrivent donc différentes couches d'adoption : distribution, inférence, expérimentation et déploiement en production. Ils doivent être lus ensemble plutôt que traités comme des mesures interchangeables de parts de marché.
Chiffres clés en un coup d'œil :
- Qwen avait atteint 942,1 millions de téléchargements cumulés sur Hugging Face en mars 2026 ; Llama avait atteint 476,0 millions.
- DeepSeek a servi 14 370 milliards de tokens sur OpenRouter entre novembre 2024 et novembre 2025.
- Les modèles ouverts gèrent environ 33 % de l'usage actif de l'IA mais ne génèrent qu'environ 4 % des revenus de l'IA, selon Mozilla.
- 79 % des développeurs ajoutant des fonctionnalités d'IA utilisent des modèles ouverts, contre 71 % pour les modèles fermés.
- Les équipes utilisant des modèles ouverts atteignent moins souvent la production : 51 %, contre 63 % pour les modèles fermés.
Statistiques de téléchargement des modèles d'IA open source par famille de modèles
The ATOM Report suit environ 1 500 modèles de langage ouverts sur Hugging Face et définit un téléchargement comme toute requête HTTP vers un endpoint de fichier de modèle, y compris les extractions automatisées par des outils tels que transformers ou curl.
La famille Qwen d'Alibaba avait accumulé 942,1 millions de téléchargements en mars 2026, tandis que la famille Llama de Meta atteignait 476,0 millions le mois. Qwen a dépassé Llama pour la première fois en septembre 2025, avec des totaux de 325,4 millions et 323,7 millions. Six mois plus tard, l'écart s'était creusé à 466,1 millions : Qwen a ajouté environ 617 millions de téléchargements sur cette période, contre environ 152 millions pour Llama.
Source : The ATOM Report, Interconnects AI, téléchargements cumulés sur Hugging Face.
DeepSeek et Mistral sont très loin derrière les deux premiers. DeepSeek a dépassé Mistral en janvier 2026, enregistrant 128,2 millions de téléchargements contre 124,3 millions. Mistral avait auparavant dominé le domaine — sa part des nouveaux modèles dérivés avait culminé à 57 % en décembre 2023, portée par Mistral 7B et Mixtral. La part de dérivés de Meta avait culminé à 44 % en août 2024 avant de tomber à 11 % en février 2026.
Les nouveaux laboratoires américains partent de bases bien plus petites. Nemotron de NVIDIA a enregistré 30,7 millions de téléchargements entre août 2025 et mars 2026, OLMo de l'Allen Institute for AI 14,8 millions, et Granite d'IBM 8,6 millions.
Les annonces des entreprises suivent d'autres règles. Meta a indiqué que Llama avait dépassé 1 milliard de téléchargements le 18 mars 2025. Google a déclaré que Gemma avait dépassé 1 milliard le 20 août 2026, un ingénieur de Google précisant que ce comptage exclut les intégrations Android et Chrome. Aucun de ces chiffres d'entreprise n'a été audité de manière indépendante, et le comptage ATOM pour Llama ne couvre que les modèles de génération de texte suivis sur Hugging Face ; les deux ensembles de chiffres ne peuvent donc pas être comparés directement.
Le volume mensuel de Qwen soutient son avance. En février 2026, Qwen a généré à lui seul 153,6 millions de téléchargements, tandis que les huit organisations suivantes de modèles ouverts en ont produit 71,2 millions à elles toutes.
Statistiques de téléchargement des modèles d'IA open source par région
ATOM attribue chaque modèle aux États-Unis, à la Chine ou à l'Europe selon le siège de l'organisation qui le publie. Le total des téléchargements suivis a atteint 2,04 milliards en mars 2026, contre 339 millions un an plus tôt.
Source : The ATOM Report, Interconnects AI, téléchargements cumulés sur Hugging Face.
Aucune région n'a régressé. En mars 2025, les États-Unis devançaient la Chine de 80 millions de téléchargements ; en mars 2026, la Chine devançait de 428 millions, ATOM situant le dépassement fin juillet 2025.
Les données d'enquête vont dans le même sens. L'enquête de Mozilla a révélé un usage des modèles ouverts à 89 % dans la Grande Chine et l'Asie de l'Est, le plus élevé de toutes les régions, l'Europe de l'Ouest étant à 70 %. Le trafic d'OpenRouter montre une évolution parallèle : l'analyse de Mozilla a constaté que les modèles open weight chinois sont passés de moins de 2 % du trafic hebdomadaire fin 2024 à 45 % en avril 2026.
Le rapport été 2026 de Hugging Face a examiné la taille des modèles. Presque chaque mois de 2026, le plus grand modèle ouvert publié par un laboratoire chinois était plus grand que tout modèle d'un laboratoire américain. Le plafond mensuel de la Chine s'est situé entre 754 et 2 780 milliards de paramètres, tandis que les modèles américains sont restés sous 130 milliards de paramètres cinq mois sur sept. AMD et NVIDIA ont chacun publié plus de 200 nouveaux dépôts de modèles en 2026 — plus que toute autre organisation — LiquidAI étant troisième avec environ 100.
Statistiques d'usage en tokens des modèles ouverts
Les téléchargements mesurent la fréquence de copie des poids ; les tokens mesurent le travail effectué par un modèle. OpenRouter et a16z ont analysé plus de 100 000 milliards de tokens de trafic réel de la plateforme de novembre 2024 à novembre 2025. DeepSeek a servi 14 370 milliards de tokens, devant Qwen à 5 590 milliards et Meta Llama à 3 960 milliards — un ordre différent du classement des téléchargements, où Qwen domine largement.
Source : OpenRouter et a16z, State of AI, tokens acheminés sur OpenRouter, novembre 2024 à novembre 2025.
Les modèles open weight représentaient environ un tiers de l'usage d'OpenRouter fin 2025. Sur la fenêtre d'un an, les modèles ouverts chinois ont représenté en moyenne 13,0 % du volume hebdomadaire de tokens, les modèles ouverts du reste du monde 13,7 %, et les modèles propriétaires du reste du monde 70 %.
La propre série OpenRouter d'ATOM montre la rapidité d'évolution des parts. DeepSeek V3 et R1 représentaient jusqu'à 75,6 % des tokens d'inférence des modèles ouverts en juin 2025, tombant à 31,1 % en janvier 2026. La part de Meta est passée d'un pic de 37,4 % en janvier 2025 à zéro en août 2025. Le leadership sur cette mesure peut changer en quelques mois.
Presenc AI, utilisant un mélange différent de sources, rapporte une part ouverte plus faible : environ 15 % des tokens d'inférence en janvier 2026, contre environ 1 % un an plus tôt. Dans cette estimation, DeepSeek détient environ 6 %, Qwen environ 5 % et Llama environ 3 %.
IA open source contre IA fermée : usage, revenus et performances
Mozilla a publié son premier rapport State of Open Source AI en juillet 2026. Il a constaté que les modèles ouverts gèrent environ 33 % de l'usage actif de l'IA mais ne captent qu'environ 4 % des revenus mondiaux de l'IA ; les modèles fermés représentent les 67 % restants de l'usage et 96 % des revenus. Cette divergence découle de la façon dont les modèles ouverts gagnent de l'argent : personne ne paie de licence par token pour exécuter des poids ouverts, donc les revenus vont à celui qui héberge le modèle — souvent l'infrastructure de l'acheteur lui-même.
D'autres sources rapportent une part d'usage plus faible. MIT Sloan, cité par TechnologyChecker, estime les modèles fermés à environ 80 % de l'usage des modèles et indique que les modèles ouverts atteignent environ 90 % des performances des modèles fermés à leur sortie.
L'écart de performance a évolué au fil du temps. Le suivi Chatbot Arena de Mozilla montre l'écart moyen passant d'environ 8,04 % à aussi bas que 0,5 % en août 2024. Il s'est ensuite creusé après la sortie de nouveaux modèles de raisonnement par les laboratoires fermés, atteignant 3,3 points de pourcentage en mars 2026.
BenchLM utilise une autre échelle. Au 20 octobre 2026, 12 de ses 50 premiers modèles (24 %) étaient open weight, tout comme 494 des 972 modèles suivis (51 %). Son meilleur modèle ouvert, MiMo-V2.6-Pro de Xiaomi, a obtenu 73,66 sur 100 et se classe 12e — 13,03 points derrière le meilleur modèle propriétaire, Claude Opus 5.5. BenchLM indique l'écart Arena Elo entre le meilleur modèle fermé et le meilleur modèle ouvert à 36,8 points au 15 octobre 202, contre 29,2 points environ un an plus tôt. La page décrit cela comme un resserrement, mais les chiffres tels qu'imprimés montrent un écart plus grand ; la tendance doit donc être lue avec prudence.
L'écart dépend aussi de la tâche. La comparaison de mai 2026 de Presenc AI montre une quasi-parité sur les tests de connaissances et de code, et une large avance des modèles fermés sur les tests de raisonnement difficiles.
Source : Presenc AI, Open Source vs Closed AI Market Share 2026. Les valeurs sont approximatives.
Des résultats individuels peuvent rompre le schéma. GLM-5.2 de Z.ai a obtenu 81,0 sur Terminal-Bench 2.1 contre 83,4 pour GPT-5.5, et sur SWE-bench Pro il a obtenu 62,1 contre 58,6 pour GPT-5.5. Le propre jeu de données de Mozilla situait le meilleur modèle ouvert à 67,9 sur Terminal-Bench 2.1 avant l'arrivée de GLM-5.2 — les données du rapport étaient déjà dépassées par la dernière sortie le jour de sa publication.
Statistiques d'adoption par les développeurs et d'usage en production
Le rapport de Mozilla s'appuie sur une enquête SlashData auprès de 1 494 développeurs, menée en mai 2026, parmi des développeurs ajoutant des fonctionnalités d'IA à des applications.
Source : enquête développeurs Mozilla et SlashData 2026, menée en mai 2026. Les deux premières lignes se chevauchent.
La production est le point de divergence entre les deux groupes. Parmi les équipes travaillant avec des modèles ouverts, 51 % atteignent la production, contre 63 % pour les modèles fermés. La page du rapport de Mozilla indique le chiffre ouvert à 53 %, tandis que son article de blog donne 51 %. Alvaro Ruiz Cubero de SlashData attribue cet écart au manque d'infrastructure plutôt qu'à la qualité des modèles.
Interrogés sur ce qui bloque les projets de modèles ouverts, les développeurs ont le plus souvent cité le coût de l'infrastructure à 27 %, suivis de la sécurité et de la conformité à 26 %, de la maintenance et des mises à jour à 24 %, et de la complexité du déploiement à 23 %. Les quatre réponses sont proches en poids, si bien qu'aucune solution unique ne résout le problème.
L'usage dépend aussi de la tâche. Presenc AI estime qu'environ 94 % des travaux en edge et on-device utilisent un modèle ouvert, avec des parts d'environ 85 % pour les travaux à fort volume sensibles aux coûts et d'environ 71 % pour les travaux sur données sensibles dans des domaines comme le droit, la finance et la santé.
Source : Presenc AI, Open Source vs Closed AI Market Share 2026.
Les résultats d'enquête dépendent de la formulation de la question. Presenc AI indique qu'environ 89 % des entreprises utilisent au moins un modèle open source en production, tandis que la Linux Foundation, citée par TechnologyChecker, a constaté que 63 % des organisations utilisent l'IA open source et que 89 % utilisent de l'open source quelque part dans leur stack d'IA.
Le déploiement web visible est bien plus faible. TechnologyChecker a analysé plus de 50 millions de domaines en mai 2026 et a constaté que Botpress, le framework d'IA open source le plus courant qu'il puisse détecter, tournait sur 1 558 domaines — contre 52 682 pour l'API fermée d'OpenAI et 1 349 pour Dialogflow de Google. Sur les 899 entreprises associées à un déploiement Botpress, 64 % comptaient 10 employés ou moins, 81 % moins de 50, et environ 5 % 1 000 ou plus. Les États-Unis représentaient environ 23 % des déploiements détectés, suivis de l'Espagne à 6,9 % et de l'Inde à 6 %. TechnologyChecker note que sa méthode ne peut pas les outils backend tels que transformers, LangChain ou Ollama ; ses comptages reflètent uniquement la couche navigateur.
Statistiques de l'écosystème Hugging Face
Le rapport printemps 2026 de Hugging Face indiquait que la plateforme avait atteint 13 millions d'utilisateurs, plus de 2 millions de modèles publics et plus de 500 000 jeux de données publics en 2025. Son rapport d'été, couvrant janvier à août 2026, a enregistré la hausse des dépôts de modèles publics de 2,43 millions à 2,96 millions, des jeux de données de 711 000 à 1 million, et des Spaces de 1,00 million à 1,44 million.
L'attention est fortement concentrée. Le rapport de printemps a constaté qu'environ la moitié de tous les modèles totalisaient moins de 200 téléchargements, et que les 200 premiers modèles — 0,01 % du total — détenaient 49,6 % de tous les téléchargements. Le rapport d'été situe la part des modèles sous 200 téléchargements à vie à 85,6 % et indique que 1,5 % des dépôts représentent 99,2 % des téléchargements. Les deux rapports comptent différemment et couvrent des périodes différentes, mais tous deux montrent la même forme : un petit groupe de modèles capturant la quasi-totalité du trafic.
Le Stanford AI Index 2026 recense environ 5,6 millions de projets liés à l'IA sur GitHub et Hugging Face, dont seulement 206 880 (3,7 %) ont 10 étoiles ou plus. Les dépôts de modèles sur Hugging Face ont plus que triplé entre 2023 et 2025, atteignant 332 000 sur un seul trimestre.
Source : Hugging Face, State of Open Source on Hugging Face : Spring 2026, publié le 17 mars 2026.
La moyenne a grandi bien plus vite que la médiane. Hugging Face crédite la quantification et les architectures mixture-of-experts d'avoir tiré le haut du panier vers le haut, tandis que l'usage des petits modèles reste stable. Les petits modèles captent toujours la majorité des téléchargements : les modèles de moins de 1 milliard de paramètres représentent 83 % des téléchargements historiques et ceux de plus de 100 milliards 1 %, tandis que pour les seuls téléchargements de 2026, 3 % sont allés aux modèles de plus de 70 milliards de paramètres.
Les likes et les téléchargements mesurent des choses différentes. Les 25 premiers dépôts par téléchargements 2026 et les 25 premiers par likes n'ont eu exactement qu'une entrée en commun. Le modèle all-MiniLM-L6-v2 a été récupéré 1,55 milliard de fois en sept mois et compte 5 156 likes.
Qwen est devenu la base sur laquelle les autres construisent. Les modèles basés sur Qwen représentent 151 448 dérivés sur le Hub — 2,6 fois le total de Meta et 4,7 fois les seuls dépôts Llama — Google suivant avec 82 506. Les dérivés de Qwen ont augmenté d'environ 180 à 210 nouveaux dépôts par jour durant les sept premiers mois de 2026.
L'exécution locale suit le même schéma. Qwen enregistre 39,6 millions de téléchargements GGUF par mois, contre 20,8 millions pour Gemma et 7,5 millions pour Llama. Le GGUF est le format utilisé par les exécuteurs locaux tels que llama.cpp.
La croissance la plus rapide se situe dans la couche runtime. Les dépôts utilisant la bibliothèque gguf ont augmenté de 464 %, lerobot de 194 % et le mlx d'Apple de 148 %, tandis que transformers et peft ont progressé de 16 % et diffusers de 21 %. Tous les dépôts de modèles ont augmenté de 21,5 %.
Les agents sont apparus comme une nouvelle classe d'utilisateurs. Claude Code représentait 44,4 % du trafic étiqueté agent vers le Hub en juillet 2026, contre 67,8 % en avril, tandis que Codex est passé de 10,4 % à 20,8 % sur les mêmes mois.
Statistiques de coûts, tarification et financement
Mozilla rapporte que l'inférence de classe GPT-4 est passée d'environ 20 dollars à environ 0,40 par million de tokens sur 36 mois — une baisse d'un facteur 50 que le rapport attribue à la concurrence des poids ouverts. Une analyse de la Linux Foundation citée dans le rapport évalue l'inférence des modèles fermés à environ six fois le coût d'un modèle ouvert comparable. Mozilla convertit cet écart en une estimation de 24,8 milliards de dollars d'économies annuelles non réalisées si les acheteurs migraient les charges de travail éligibles vers des poids ouverts. À titre d'exemple, Stripe a réduit ses coûts d'inférence de 73 % tout en gérant 50 millions d'appels API quotidiens en déplaçant une partie de son travail d'IA vers des modèles ouverts.
Les grilles tarifaires des fournisseurs illustrent l'éventail. La comparaison de mai 2026 de Presenc AI liste DeepSeek V4 à 0,14 dollar par million de tokens d'entrée, contre 3,00 dollars pour GPT-5.5 et Claude 4.7 Opus.
Source : Presenc AI, Open Source vs Closed AI Market Share 2026, prix fournisseurs de mai 2026.
Les petits modèles fermés sont proches des prix des modèles ouverts, GPT-5.5 mini étant listé à 0,15 dollar et Gemini 3.1 Flash à 0,075 dollar — dans les gammes inférieures, le prix seul ne distingue pas l'ouvert du fermé.
Les entreprises construites sur des modèles ouverts commencent à publier leurs revenus. Le rapport de Mozilla liste Databricks à un rythme annualisé de 5,4 milliards de dollars et Mistral AI à environ 400 millions de dollars de revenus récurrents annuels, une multiplication par 20 en douze mois. DeepSeek est à environ 220 millions de dollars et a levé 7,4 milliards de dollars pour une valorisation supérieure à 50 milliards de dollars. Mistral a annoncé une série C de 1,7 milliard d'euros le 9 septembre 2025, pour une valorisation post-money de 11,7 milliards d'euros, menée par ASML. Zhipu AI et MiniMax préparent toutes deux des introductions en bourse à Hong Kong en 2026. En mai 2026, IBM et Red Hat ont promis 5 milliards de dollars pour les outils et l'infrastructure de l'IA open source. Market.us projette que le marché des modèles d'IA open source passera de 19,05 milliards de dollars en 2025 à 23,08 milliards en 2026, soit environ 21 %.
Les licences indiquent d'où ne vient pas le retour. Sur 178 publications chinoises de plus de 20 milliards de paramètres en 2026, 59 % utilisent Apache 2.0 et 22 % MIT. Pour les publications américaines de la même gamme de taille, 29 % utilisent Apache ou MIT, 41 % des conditions personnalisées et 30 % ne déclarent rien. Hugging Face note que certaines des plus grandes publications récentes, comme Kimi K3 et Qwen 3.8 2.4T, ont commencé à ajouter des restrictions non commerciales ou des conditions de partage de revenus — le paysage des licences évolue.
Sources
- The ATOM Report (arXiv)
- OpenRouter, State of AI
- Hugging Face, State of Open Source on Hugging Face: Spring 2026
- State of Open Source AI (Mozilla)
- BenchLM, Open Source LLM Statistics (2026)
- Hugging Face, State of Open Models: Summer 2026 Observations
- TechnologyChecker, Open-Source AI Adoption 2026
- Tech Insider, Open-Source AI Powers 33% of Use, Just 4% of Revenue
- Presenc AI, Open vs Closed AI Market Share 2026
- Command Linux, Open-Source AI Model Download Statistics 2026
Cet article a été publié à l'origine sur Blockonomi.

