Le département de la Justice américain soutient la thèse du fair use d'OpenAI et met en garde contre un oligopole des licences d'IA
Points clés
- •Le département de la Justice a déposé un mémoire d'intérêt soutenant que l'utilisation par OpenAI d'écrits protégés pour l'entraînement de ses modèles devrait être protégée par le fair use.
- •Le gouvernement a averti qu'une licence obligatoire des textes d'entraînement créerait des barrières à l'entrée, favorisant les entreprises fortunées et les éditeurs établis tout en marginalisant les petits développeurs.
- •Le mémoire n'offre pas de protection générale : il distingue l'entraînement des productions reproduisant du matériel protégé et la manière dont les données d'entraînement sont obtenues.
- •Le New York Times et Mary Rasenberger, directrice de la Authors Guild, ont critiqué la position du gouvernement, que le juge Sidney Stein reste libre d'ignorer.
- •Goldman Sachs Research prévoit que l'investissement mondial lié à l'IA dépassera 1 000 milliards de dollars en 2026, dont 581 milliards aux États-Unis.
Le département de la Justice américain a déclaré mardi à un tribunal fédéral de Manhattan que l'utilisation par OpenAI d'écrits protégés par le droit d'auteur lors de l'entraînement de ses modèles devrait être protégée par le fair use — une position qui pourrait remodeler l'économie de l'industrie mondiale de l'IA, alors que l'investissement mondial devrait dépasser 1 000 milliards de dollars cette année.
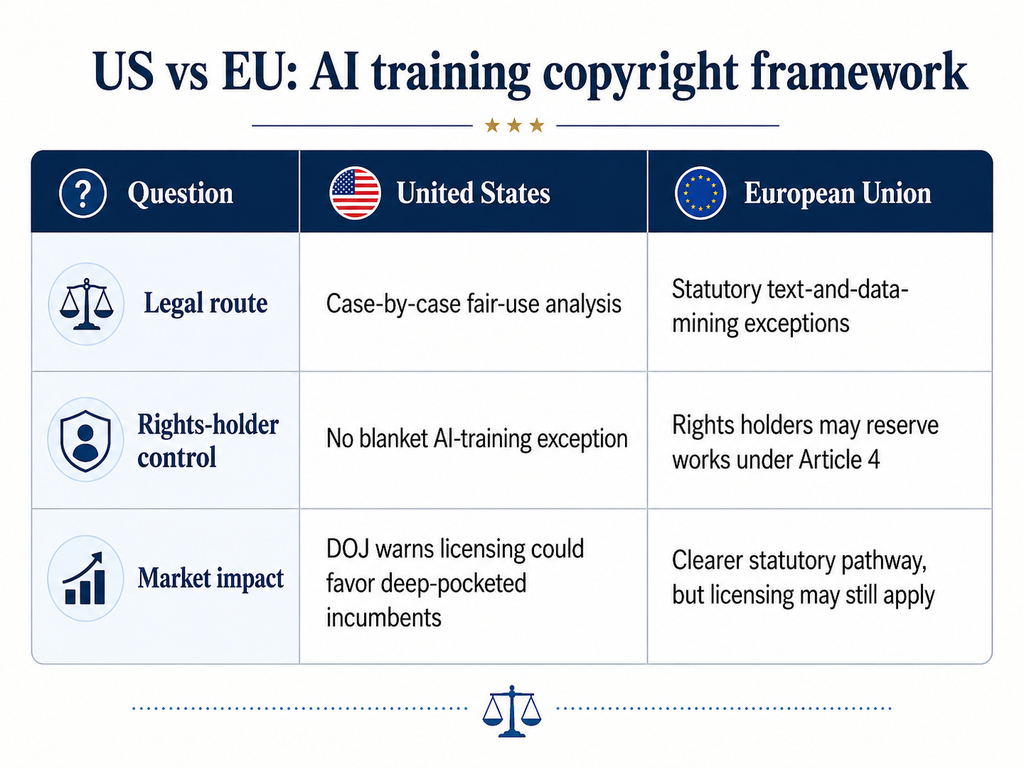
Dans un mémoire d'intérêt déposé dans le procès consolidé en droit d'auteur contre OpenAI, le gouvernement a averti que si les développeurs étaient tenus d'obtenir une licence pour les textes d'entraînement, seules les entreprises fortunées seraient en mesure de continuer à construire des technologies d'IA de pointe.
Le gouvernement a formulé son argumentation à la fois en termes juridiques et économiques : une licence obligatoire pourrait créer des obstacles majeurs à l'entrée sur le marché, renforcer les entreprises technologiques en place et transférer une grande partie des profits qui en découlent aux éditeurs établis détenant les archives les plus vastes.
Les mémoires d'intérêt comme celui-ci ne tranchent pas l'affaire ; ils permettent au gouvernement fédéral de faire connaître son avis sur des questions pendantes devant un tribunal, et les juges restent libres d'en tenir compte ou de les ignorer.
Pourquoi Washington qualifie un régime de licences de barrière à l'entrée
Selon le département de la Justice, imposer un coût sur les informations utilisées pour entraîner l'IA pourrait marginaliser les petits développeurs au profit des acteurs plus importants. Cela rejoint un rapport de l'OCDE concluant que l'accès à la puissance de calcul, aux données et à l'expertise sur le marché actuel de l'IA est déjà concentré et continuera de favoriser les entreprises bien établies.
Washington a également soutenu que les petits créateurs bénéficient d'outils d'IA peu coûteux. Les auteurs, en particulier, peuvent utiliser les modèles pour générer des images qu'ils ne pourraient pas se permettre autrement, ou pour trouver des sources et des perspectives qui leur échapperaient sinon.
Le bureau américain du droit d'auteur (US Copyright Office) a toutefois adopté une position plus nuancée, indiquant dans son propre rapport sur l'entraînement de l'IA générative que certains usages d'entraînement peuvent être couverts par le fair use et d'autres non, selon la source du matériel, l'usage visé et l'impact sur le marché.
L'argument de l'usage transformatif au cœur du débat
Le département de la Justice s'est fortement appuyé sur le premier facteur du fair use, décrivant l'entraînement de l'IA comme « extraordinairement transformatif ». En vertu du droit d'auteur américain, le fair use s'apprécie en pondérant plusieurs facteurs légaux — notamment l'objet et le caractère de l'utilisation, la nature de l'œuvre, la quantité utilisée et l'effet sur le marché de l'œuvre originale. Le gouvernement a soutenu que les copies d'entraînement servent un but différent de celui des articles originaux et que les bénéfices de l'IA « l'emportent de loin sur tout préjudice concurrentiel ».
Le mémoire n'accorde toutefois pas une protection générale aux développeurs d'IA. Il fait une distinction entre l'entraînement des modèles et les productions qui reproduisent du matériel protégé par le droit d'auteur, ainsi qu'entre les questions relatives à la manière dont les données d'entraînement sont obtenues.
Cette distinction est visible dans les affaires californiennes. Une analyse de la Copyright Alliance des dossiers Bartz v. Anthropic et Kadrey v. Meta relève que les deux tribunaux ont jugé l'entraînement transformatif, tout en parvenant à des conclusions différentes sur le piratage et le préjudice causé au marché.
Le procureur général adjoint Stanley Woodward Jr. a qualifié ce mémoire de « déclaration d'intérêt historique », reliant la position de l'administration en matière de droit d'auteur à l'objectif plus large de maintenir la position des États-Unis dans le domaine de l'IA.
Sécurité nationale et course contre les rivaux étrangers
Le mémoire présente également les règles du droit d'auteur comme un enjeu de politique industrielle et de sécurité nationale, arguant que des coûts de développement plus élevés pourraient désavantager les entreprises américaines face à leurs concurrents étrangers.
Les enjeux sont considérables. Selon les prévisions de Goldman Sachs Research, l'investissement mondial lié à l'IA dépassera 1 000 milliards de dollars en 2026, dont 581 milliards aux États-Unis.
L'Union européenne a emprunté une voie différente. Sa directive sur le marché unique numérique prévoit des exceptions explicites au texte et à l'exploration de données, bien que les titulaires de droits puissent retirer leurs œuvres de certaines formes d'exploration. Une décision américaine sur le fair use interviendrait donc dans un contexte où les deux plus grands marchés occidentaux ont déjà divergé dans leur réglementation des données d'entraînement de l'IA.
Ce que disent les éditeurs et le tribunal ensuite
Le New York Times, qui a poursuivi OpenAI et Microsoft en 2023, a rejeté la position de Washington.
Mary Rasenberger, directrice générale de la Authors Guild, a été tout aussi critique, déclarant à WIRED que le mémoire « déçoit extrêmement » et est « truffé d'arguments erronés et d'une profonde incompréhension de la doctrine du fair use et du droit d'auteur ».
La spécialiste du droit d'auteur de Berkeley Pamela Samuelson a décrit l'intervention du gouvernement avec plus de réserve, la qualifiant de « développement significatif ».
Le juge Sidney H. Stein, qui préside l'affaire, n'est pas tenu de suivre la position du département de la Justice.
Une décision en faveur d'OpenAI pourrait laisser une question cruciale sans réponse : la manière dont les données d'entraînement sont obtenues. Comme l'a souligné Cryptopolitan, le règlement de 1,5 milliard de dollars entre Anthropic et des auteurs portait sur des copies pirates du matériel d'entraînement — et non sur l'acte d'entraînement lui-même.
Cette différence peut avoir une grande importance. Même si l'entraînement est considéré comme relevant du fair use, les développeurs d'IA restent exposés à un risque juridique majeur s'ils obtiennent illégalement le matériel utilisé pour construire leurs modèles.

