Coûts des modèles d'IA : les dépenses d'entraînement s'envolent pendant que les prix d'inférence s'effondrent
Points clés
- •Epoch AI estime que le coût amorti en matériel et énergie des entraînements d'IA de pointe a augmenté d'environ 2,4 fois par an depuis 2016, et projette que les plus grands entraînements pourraient dépasser 1 milliard de dollars vers 2027 si la tendance se maintient.
- •Le calcul d'entraînement estimé atteint environ 79 millions de dollars pour GPT-4, 192 millions pour Gemini 1.0 Ultra et 170 millions pour Llama 3.1 405B, le matériel représentant 47 % à 67 % des coûts de développement de pointe et le personnel de recherche 29 % à 49 % de plus.
- •DeepSeek a annoncé environ 5,576 millions de dollars de calcul d'entraînement pour DeepSeek-V3, sur la base d'environ 2,788 millions d'heures GPU Nvidia H800, un chiffre qui exclut les recherches antérieures, les études d'ablation et autres dépenses de développement.
- •Le coût pour atteindre un niveau de performance IA fixe a diminué d'environ 47 % par trimestre depuis 2023, soit environ 13 fois par an, un rythme qu'Epoch AI juge plus rapide que les courbes de coûts antérieures comme le séquençage de l'ADN et les batteries lithium-ion.
- •L'inférence de niveau GPT-3.5 est passée d'environ 20 dollars par million de tokens fin 2022 à 0,07 dollar en octobre 2024, et en octobre 2026 les petits modèles commerciaux comme GPT-6 Luna et Claude Haiku 5.5 facturaient 0,10 dollar par million de tokens d'entrée et 0,50 dollar par million de tokens de sortie.
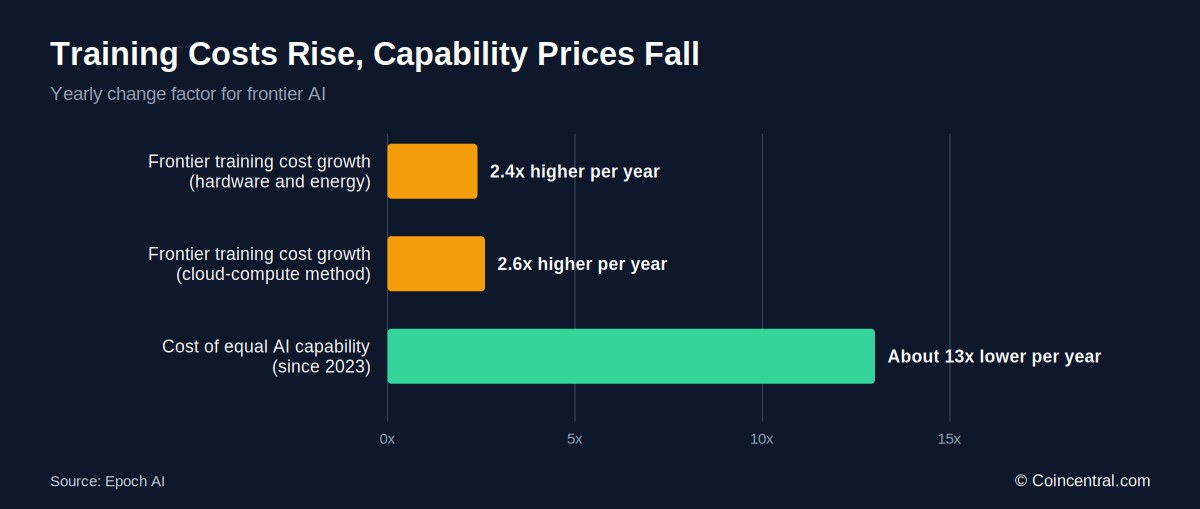
L'intelligence artificielle est entrée dans une ère d'économie bifide : le coût de construction des modèles de pointe ne cesse de grimper, tandis que le coût de leur utilisation ne cesse de baisser. Les deux tendances progressent en même temps.
L'entraînement d'un modèle d'IA de pointe peut nécessiter des dizaines, voire des centaines de millions de dollars de puissance de calcul. Epoch AI estime que le coût matériel et énergétique de ces entraînements a augmenté d'environ 2,4 fois par an.
Une fois le modèle entraîné, la situation s'inverse. Selon Epoch AI, le prix pour atteindre un niveau de performance fixe a diminué d'environ 47 % chaque trimestre depuis 2023 — soit environ une baisse de 13 fois par an.
Cet article compile les chiffres essentiels sur les coûts d'entraînement, les coûts d'inférence et la tarification des tokens, en s'appuyant sur des données d'Epoch AI, de l'université Stanford, de DeepSeek, d'OpenAI, d'Anthropic et de Google. Tous les prix sont des tarifs standard publiés en date d'octobre 2026.
Statistiques des coûts des modèles d'IA en un coup d'œil
- Les coûts d'entraînement de l'IA de pointe ont augmenté d'environ 2,4 fois par an.
- Epoch AI projette que les plus grands entraînements pourraient dépasser 1 milliard de dollars vers 2027 si la tendance se maintient.
- Le calcul d'entraînement de GPT-4 est estimé à environ 79 millions de dollars.
- Gemini 1.0 Ultra est estimé à environ 192 millions de dollars.
- Llama 3.1 405B est estimé à environ 170 millions de dollars.
- Grok-2 est estimé à environ 107 millions de dollars.
- DeepSeek a annoncé 5,576 millions de dollars pour l'entraînement officiel de DeepSeek-V3, un chiffre qui exclut les recherches antérieures et les coûts de personnel.
- Le matériel représente environ 47 % à 67 % des coûts de développement des modèles de pointe ; le personnel de recherche et développement en compte 29 % à 49 % de plus.
- L'énergie ne représente qu'environ 2 % à 6 %.
- Le coût d'une performance IA équivalente baisse d'environ 47 % par trimestre, soit environ 13 fois par an.
- L'inférence de niveau GPT-3.5 a chuté de plus de 280 fois entre fin 2022 et fin 2024.
- GPT-6 Luna et Claude Haiku 5.5 coûtent 0,10 dollar par million de tokens d'entrée et 0,50 dollar par million de tokens de sortie.
- Les tokens mis en cache peuvent être 90 % à 95 % moins chers que les tokens d'entrée ordinaires sur certaines API.
L'écart croissant entre la hausse des coûts d'entraînement et la baisse des coûts d'utilisation se situe au cœur de l'économie de l'IA. Le reste de cet article examine chaque aspect tour à tour.
Combien coûte l'entraînement d'un modèle d'IA ?
Il n'y a pas de réponse unique. Les coûts vont de quelques centaines de dollars pour les premiers modèles de recherche à des centaines de millions de dollars pour les systèmes de pointe.
L'AI Index de Stanford, utilisant des estimations élaborées avec Epoch AI, suit l'évolution des coûts d'entraînement. Stanford précise que ces chiffres estiment surtout les ressources de calcul consommées plutôt que le coût économique complet de la construction de chaque modèle. Cela dit, l'évolution sur sept ans est spectaculaire : le Transformer original coûtait moins de 1 000 dollars de calcul estimé pour son entraînement, tandis que GPT-4 a coûté environ 79 millions de dollars — plus de 100 000 fois plus.
Tous les modèles ne suivent pas cette courbe ascendante. Llama 2 70B, à environ 3 millions de dollars, a coûté moins que GPT-3 à 4 millions de dollars et bien moins que PaLM 540B à 12 millions de dollars. La taille du modèle, le type de puces et la méthode d'entraînement façonnent tous la facture finale.
Les coûts d'entraînement de pointe augmentent de 2 à 3 fois par an
Epoch AI a étudié des dizaines de systèmes d'IA majeurs et estime que le coût amorti en matériel et énergie des entraînements de pointe a augmenté d'environ 2,4 fois par an depuis 2016. Une méthode distincte fondée sur les prix du calcul en cloud a trouvé un rythme similaire de 2,6 fois par an. Deux approches indépendantes convergeant vers la même fourchette renforcent la crédibilité de l'estimation.
Si la tendance se maintient, Epoch projette que les plus grands modèles de pointe pourraient dépasser 1 milliard de dollars par entraînement vers 2027. Stanford notait en 2026 que les estimations du secteur pour les nouveaux systèmes de pointe s'étendent désormais de plusieurs centaines de millions de dollars à près de 1 milliard par itération.
Cela ne signifie pas que chaque futur modèle de premier plan coûtera un milliard de dollars. Les architectures en mélange d'experts, de meilleures données, des algorithmes améliorés et un matériel moins cher peuvent tous réduire le calcul nécessaire pour atteindre un niveau de performance donné. DeepSeek a démontré l'ampleur que cet écart peut prendre.
Coût d'entraînement de DeepSeek-V3
DeepSeek a suscité une large attention après avoir annoncé un coût de calcul d'entraînement d'environ 5,576 millions de dollars pour DeepSeek-V3. Son rapport technique indique que le processus officiel complet d'entraînement a utilisé environ 2,788 millions d'heures GPU sur des Nvidia H800. À un prix de location supposé de 2 dollars par heure GPU, le total correspond au chiffre de 5,576 millions de dollars.
Ce nombre est souvent mal interprété. Ce n'est pas le coût total de développement du V3. DeepSeek a indiqué que ce chiffre exclut les recherches antérieures, les expériences d'architecture, les études d'ablation, le travail sur les données et autres coûts de développement. Pour cette raison, il ne peut pas être comparé directement à des estimations incluant des dépenses de R\u0026D plus larges ; une comparaison équitable exige le même périmètre des deux côtés.
Ce que le chiffre démontre, c'est que les choix de conception et d'ingénierie peuvent réduire fortement le coût d'un entraînement final de grande ampleur — une conclusion aux implications pour toute l'industrie.
Le calcul ne représente qu'une partie du coût
Construire un modèle de pointe demande plus que des GPU. Epoch AI estime que le coût total de développement se répartit en trois grands postes : le matériel représente environ 47 % à 67 %, le personnel de recherche et développement 29 % à 49 % de plus, et l'énergie seulement environ 2 % à 6 %.
Les coûts supplémentaires peuvent inclure l'acquisition et le nettoyage des données, les expériences ratées, le post-entraînement et l'apprentissage par renforcement. Les tests de sécurité, les évaluations de modèles, la mise en réseau, le stockage et les installations de centres de données s'ajoutent au total.
Par conséquent, le coût affiché d'un entraînement final peut sous-estimer considérablement ce qu'il faut pour construire un modèle de pointe compétitif, et l'écart entre les deux chiffres peut être important.
Inférence et tarification des tokens
Entraînement vs inférence
L'entraînement crée un modèle ; l'inférence l'exécute. Les entreprises paient l'inférence chaque fois que quelqu'un utilise le modèle. Si des millions de personnes utilisent un modèle chaque jour, les dépenses totales d'inférence peuvent dépasser le coût de l'entraînement initial.
Cette dynamique prend davantage d'importance à mesure que l'IA s'invite dans les agents de codage, la recherche IA, le service client, les assistants vocaux, l'analyse vidéo et l'automatisation des entreprises. Une réponse de chatbot de quelques centaines de tokens est bon marché ; un agent de codage qui lit des millions de tokens, appelle des outils à répétition et fonctionne pendant des heures consomme bien plus de calcul.
Prix actuels des tokens
La plupart des API IA commerciales facturent au token. Un token est un petit fragment de texte, et un million de tokens correspond à des centaines de milliers de mots anglais, même si le ratio exact varie.
La tarification de Gemini 4 Argon à 2 et 10 dollars est introductory jusqu'au 30 novembre 2026. Google indique que la tarification standard passera ensuite à 4 dollars pour l'entrée et 20 dollars pour la sortie.
Ce sont des prix catalogue. Ce ne sont pas les coûts propres des fournisseurs pour faire tourner les modèles.
Petits modèles vs modèles de pointe
Le GPT-6 Luna d'OpenAI facture 0,10 dollar par million de tokens d'entrée et 0,50 dollar par million de tokens de sortie. Le Claude Haiku 5.5 d'Anthropic affiche le même prix de référence pour les prompts de moins de 100 000 tokens. Anthropic a lancé Haiku 5.5 en octobre 2026 et indique que le modèle coûte en moyenne environ 75 % moins cher à faire tourner que Haiku 4.5.
À ces tarifs, une entreprise qui envoie 100 millions de tokens d'entrée à un modèle à 0,10 dollar ne paie que 10 dollars, tandis que 10 millions de tokens de sortie à 0,50 dollar par million coûtent 5 dollars de plus. La sortie coûte plus cher car les modèles génèrent les tokens un par un, ce qui exige plus de calcul.
Les modèles bon marché ne conviennent pas à toutes les tâches. Les systèmes de raisonnement de pointe exigent beaucoup plus de calcul, et les fournisseurs facturent en conséquence : Anthropic liste Claude Opus 5.5 à 4 dollars par million de tokens d'entrée et 20 dollars par million de tokens de sortie — 40 fois le prix de sortie de Haiku 5.5.
Cet écart donne aux agents IA une incitation claire à diriger les tâches simples vers les petits modèles, en réservant les modèles coûteux aux raisonnements complexes.
Les coûts d'inférence de l'IA ont fortement chuté
L'AI Index de Stanford offre un exemple frappant. En novembre 2022, une performance de niveau GPT-3.5 sur le benchmark MMLU coûtait environ 20 dollars par million de tokens. En octobre 2024, Gemini 1.5 Flash-8B atteignait le même niveau pour 0,07 dollar par million de tokens — une baisse de plus de 280 fois en moins de deux ans.
Stanford a constaté que les prix d'inférence ont chuté entre 9 et 900 fois par an, selon la tâche mesurée. La fourchette est large car chaque benchmark et chaque niveau de performance a sa propre histoire de prix.
La baisse des marges n'est pas la seule cause. Les modèles d'IA et le matériel qui les fait tourner sont devenus bien plus efficaces.
Le prix d'une capacité IA équivalente baisse de 13 fois par an
La recherche d'Epoch AI de septembre 2026 va au-delà des prix bruts des tokens et mesure ce qu'il coûte d'atteindre un niveau de performance fixe. Epoch estime que ce coût a diminué d'environ 47 % chaque trimestre depuis 2023. Sur une année complète, cela représente une baisse d'environ 13 fois.
Le calcul est simple. Si le prix baisse de 47 % chaque trimestre, il en reste 53 %. Après quatre trimestres, il reste environ 7,9 % — soit près d'un treizième.
Epoch indique que cette baisse est plus rapide que les grandes courbes de coûts technologiques antérieures, notamment le séquençage de l'ADN, l'informatique générale, les batteries lithium-ion et les coûts de l'électricité. Le rythme varie selon la tâche.
Matériel et logiciels rendent l'IA moins chère à exécuter
L'inférence IA bénéficie de gains constants dans l'économie des puces, que Stanford suit à travers trois tendances annuelles pour le matériel d'apprentissage automatique. Les GPU modernes utilisent également des formats numériques de plus faible précision, de meilleurs systèmes de mémoire et des liaisons plus rapides entre puces. Chaque changement permet à un centre de données de faire plus de travail pour le même argent.
Le logiciel amplifie ces gains. Des techniques comme la quantification, la distillation, la parcimonie, les architectures en mélange d'experts, le décodage spéculatif, le batching continu et de meilleurs compilateurs réduisent tous le calcul nécessaire par réponse. Ainsi, la même capacité IA peut être délivrée avec moins de ressources de calcul au fil du temps.
Le caching et le traitement par lots réduisent encore les coûts
Les API modernes accordent de plus en plus de remises sur les informations répétées. Imaginez un agent IA qui envoie le même manuel d'entreprise de 100 pages avec chaque requête : un fournisseur peut mettre ce texte en cache au lieu de le traiter à nouveau à chaque fois.
OpenAI facture 0,20 dollar par million de tokens d'entrée en cache pour GPT-6 Sol, contre 2 dollars pour l'entrée ordinaire — une remise de 90 %. Le Gemini 4 Argon de Google applique actuellement une remise de 95 % sur les entrées implicitement mises en cache éligibles.
Les utilisateurs qui n'ont pas besoin de réponses instantanées peuvent aussi payer moins. OpenAI facture les traitements Batch et Flex pour GPT-6 Sol à environ 50 % des tarifs standards. Le traitement par lots convient à la classification de documents, l'analyse de nuit, l'extraction de données, le résumé à grande échelle et les évaluations hors ligne.
La tarification de l'IA commence à ressembler à celle du cloud computing, les clients payant des tarits différents selon la vitesse, la fiabilité et la flexibilité de la charge de travail.
Coût par tâche et dépenses totales en IA
Pourquoi le prix par token peut induire en erreur
Un modèle à 1 dollar par million de tokens n'est pas toujours moins cher qu'un modèle à 2 dollars. Supposons que le premier ait besoin de 5 millions de tokens pour accomplir une tâche, tandis que le second n'en utilise qu'1 million. Le premier coûte 5 dollars pour la tâche, le second 2 dollars.
Les modèles de raisonnement rendent cette vérification encore plus importante, car ils peuvent produire de grandes quantités de tokens de réflexion internes — dont certains sont facturés. Anthropic indique que Claude Sonnet 5.5 utilise moins de tokens par tâche que Sonnet 5, ce qui peut le rendre moins cher dans des flux de travail réels, même là où les prix catalogue semblent similaires. Les entreprises suivent de plus en plus le coût par tâche menée à bien plutôt que le seul coût par million de tokens.
Ce qui maintient la baisse des prix
Trois forces poussent les coûts d'inférence à la baisse : un matériel plus efficace, des architectures de modèles plus efficaces et une forte concurrence entre fournisseurs.
OpenAI a réduit d'environ 50 % les prix d'API de GPT-6 Sol et Luna par rapport à leurs équivalents promotionnels GPT-5.6, tout en améliorant les capacités. Anthropic indique que Haiku 5.5 coûte environ 75 % moins cher par charge de travail typique que Haiku 4.5. Google rivalise aussi sur la tarification des tokens.
Résultat : des usages de l'IA trop coûteux il y a deux ou trois ans peuvent désormais s'intégrer dans des produits ordinaires.
La baisse des coûts peut augmenter les dépenses totales
Une IA moins chère ne signifie pas toujours des dépenses sectorielles plus faibles. Une entreprise pourrait ne pas automatiser un million de conversations clients si chacune coûte 1 dollar. À un centime pièce, elle pourrait toutes les automatiser.
Le schéma rappelle le paradoxe de Jevons, où une utilisation plus efficace d'une ressource conduit à une utilisation totale accrue. Cela pourrait aider à expliquer pourquoi les plus grandes entreprises du cloud continuent de dépenser des centaines de milliards de dollars en centres de données IA alors même que le coût de chaque requête baisse.
L'essentiel
L'économie de l'IA évolue dans deux directions à la fois. À la frontière, les coûts d'entraînement ont fortement augmenté : GPT-4 a nécessité environ 79 millions de dollars de calcul d'entraînement, Gemini 1.0 Ultra environ 192 millions et Llama 3.1 405B environ 170 millions, Epoch AI estimant que les coûts d'entraînement de pointe ont augmenté d'environ 2,4 fois par an.
Une fois les modèles disponibles, leur coût d'utilisation baisse rapidement. L'inférence de niveau GPT-3.5 est passée d'environ 20 dollars par million de tokens en 2022 à 0,07 dollar en 2024, et des recherches plus récentes d'Epoch chiffrent la baisse du coût d'un niveau de performance IA fixe à environ 47 % par trimestre, soit environ 13 fois par an. En octobre 2026, les petits modèles commerciaux coûtaient jusqu'à 0,10 dollar par million de tokens d'entrée et 0,50 dollar par million de tokens de sortie.
En résumé, les modèles les plus avancés coûtent plus cher à construire, tandis que leur production coûte moins cher à utiliser. Si cela se poursuit, l'effet de l'IA pourrait dépendre moins du coût d'entraînement d'un modèle que de ce qui se passe quand des milliards de personnes et d'entreprises peuvent accéder à une IA performante à des prix proches de ceux des logiciels cloud ordinaires.
Sources
- Epoch AI : The Plunging Price of Thought
- Epoch AI : How Much Does It Cost to Train Frontier AI Models?
- Université Stanford : 2025 AI Index Report, Research and Development
- Université Stanford : 2026 AI Index Report
- DeepSeek : DeepSeek-V3 Technical Report
- OpenAI : Introducing GPT-6 Sol and Luna
- OpenAI : API Pricing
- Anthropic : Claude Haiku 5.5
- Anthropic : Claude Sonnet 5.5
- Google AI : Gemini 4 Argon Pricing
Cet article est initialement paru sur CoinCentral.

