Modelos de IA de código abierto en 2026: las cifras de descargas, uso y adopción
Puntos clave
- •Qwen, de Alibaba, había alcanzado 942,1 millones de descargas acumuladas en Hugging Face para marzo de 2026, aproximadamente el doble del total de Llama de Meta, de 476,0 millones.
- •Mozilla estima que los modelos abiertos gestionan cerca del 33% del uso activo de IA pero capturan solo alrededor del 4% de los ingresos globales de IA.
- •Los modelos abiertos de China superaron a Estados Unidos en descargas acumuladas a finales de julio de 2025 y lideraban por 428 millones al cierre de marzo de 2026.
- •Solo el 51% de los equipos que trabajan con modelos abiertos llega a producción, frente al 63% de los modelos cerrados, una brecha atribuida principalmente a la falta de infraestructura más que a la calidad del modelo.
- •Los costos de inferencia de los modelos de clase GPT-4 cayeron unas 50 veces en 36 meses, de unos $20 a $0,40 por millón de tokens, una caída que el informe vincula a la competencia de los pesos abiertos.
Los modelos de IA de código abierto son ahora componentes habituales del desarrollo de software. Los desarrolladores los descargan, construyen aplicaciones sobre ellos y los ejecutan en su propio hardware. Varias organizaciones intentan medir esta actividad, y sus cifras no siempre coinciden. Este informe coloca las principales cifras una al lado de la otra, cubriendo descargas, uso de tokens, cambios regionales, costos, encuestas a desarrolladores y financiamiento de empresas. Cada cifra incluye su fuente, su fecha y una nota sobre lo que realmente cuenta.
Una advertencia aplica a todas las métricas siguientes. Una descarga es una solicitud de archivo, no una persona. Un conteo de tokens mide el trabajo realizado, no las copias hechas. La mayoría de los modelos abiertos se describen con mayor precisión como modelos de pesos abiertos: los parámetros entrenados son públicos, pero los datos de entrenamiento y el código a menudo no lo son. Por lo tanto, las cifras describen diferentes capas de adopción: distribución, inferencia, experimentación y despliegue en producción. Deben leerse en conjunto y no tratarse como medidas intercambiables de participación de mercado.
Cifras clave de un vistazo:
- Qwen había alcanzado 942,1 millones de descargas acumuladas en Hugging Face para marzo de 2026; Llama había alcanzado 476,0 millones.
- DeepSeek sirvió 14,37 billones de tokens en OpenRouter entre noviembre de 2024 y noviembre de 2025.
- Los modelos abiertos gestionan alrededor del 33% del uso activo de IA pero generan cerca del 4% de los ingresos de IA, según Mozilla.
- El 79% de los desarrolladores que agregan funciones de IA usan modelos abiertos, frente al 71% de los modelos cerrados.
- Los equipos que usan modelos abiertos llegan a producción con menos frecuencia: 51%, frente al 63% de los modelos cerrados.
Estadísticas de descargas de IA de código abierto por familia de modelos
El ATOM Report realiza un seguimiento de aproximadamente 1.500 modelos de lenguaje abiertos en Hugging Face y define una descarga como cualquier solicitud HTTP al endpoint de un archivo de modelo, incluidas las descargas automatizadas de herramientas como transformers o curl.
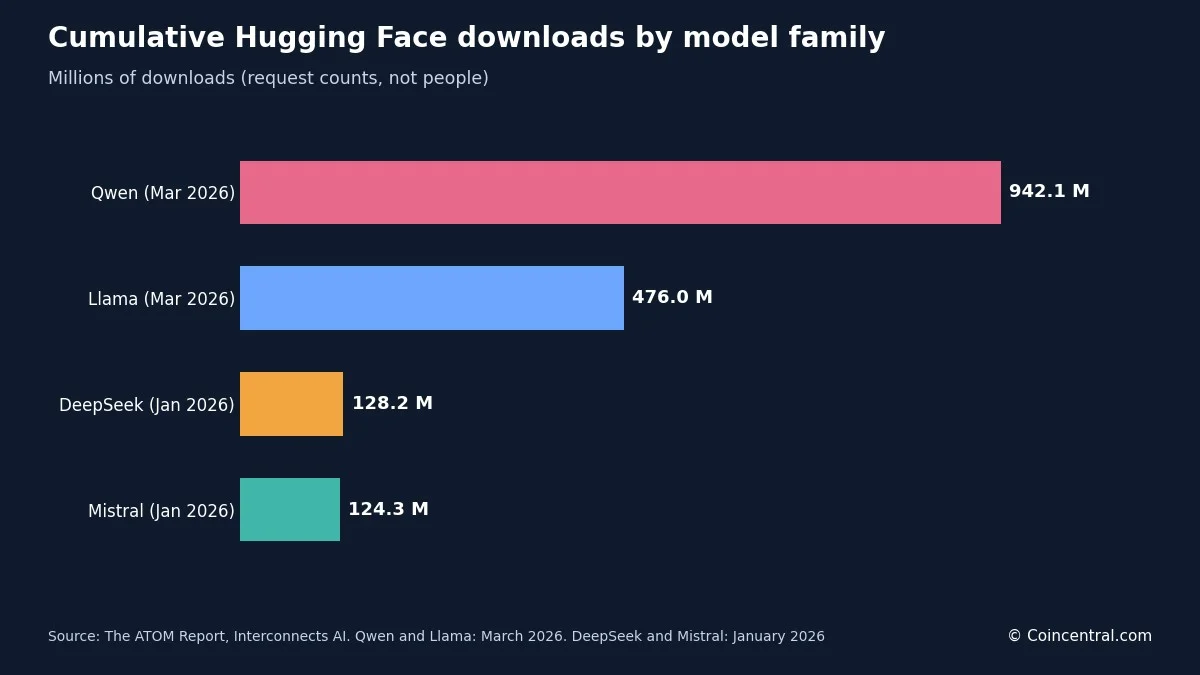
La familia Qwen de Alibaba había acumulado 942,1 millones de descargas para marzo de 2026, mientras que la familia Llama de Meta se situaba en 476,0 millones en el mismo mes. Qwen superó a Llama por primera vez en septiembre de 2025, cuando los totales eran de 325,4 millones y 323,7 millones. Seis meses después, la brecha se había ampliado a 466,1 millones: Qwen agregó unos 617 millones de descargas en ese período, mientras que Llama agregó unos 152 millones.
Fuente: The ATOM Report, Interconnects AI, descargas acumuladas en Hugging Face.
DeepSeek y Mistral están muy por detrás de los dos primeros. DeepSeek superó a Mistral en enero de 2026, registrando 128,2 millones de descargas frente a 124,3 millones. Mistral había liderado antes el campo: su participación en nuevos modelos derivados alcanzó un pico del 57% en diciembre de 2023, impulsada por Mistral 7B y Mixtral. La participación de derivados de Meta alcanzó un pico del 44% en agosto de 2024 y había caído al 11% para febrero de 2026.
Los laboratorios más nuevos de EE. UU. parten de bases mucho más pequeñas. Nemotron de NVIDIA registró 30,7 millones de descargas entre agosto de 2025 y marzo de 2026, OLMo del Allen Institute for AI registró 14,8 millones y Granite de IBM registró 8,6 millones.
Los anuncios corporativos siguen reglas distintas. Meta dijo que Llama superó los 1.000 millones de descargas el 18 de marzo de 2025. Google dijo que Gemma superó los 1.000 millones el 20 de agosto de 2026, y un ingeniero de Google señaló que el conteo excluye las integraciones de Android y Chrome. Ninguna de las dos cifras corporativas ha sido auditada de forma independiente, y el conteo de ATOM para Llama cubre solo los modelos de generación de texto rastreados en Hugging Face, por lo que ambos conjuntos de números no pueden compararse directamente.
El volumen mensual de Qwen sustenta su liderazgo. En febrero de 2026, Qwen por sí solo generó 153,6 millones de descargas, mientras que las siguientes ocho organizaciones de modelos abiertos combinadas produjeron 71,2 millones.
Estadísticas de descargas de IA de código abierto por región
ATOM asigna cada modelo a Estados Unidos, China o Europa según la sede de la organización que lo publica. El total de descargas rastreadas alcanzó los 2.040 millones para marzo de 2026, frente a 339 millones un año antes.
Fuente: The ATOM Report, Interconnects AI, descargas acumuladas en Hugging Face.
Ninguna región disminuyó. En marzo de 2025, Estados Unidos lideraba a China por 80 millones de descargas; para marzo de 2026, China lideraba por 428 millones, con ATOM situando el cruce a finales de julio de 2025.
Los datos de encuestas apuntan en la misma dirección. La encuesta de desarrolladores de Mozilla encontró un uso de modelos abiertos del 89% en la Gran China y Asia Oriental, el más alto de todas las regiones, con Europa Occidental en el 70%. El tráfico de OpenRouter muestra un cambio paralelo: el análisis de Mozilla encontró que los modelos abiertos chinos crecieron de menos del 2% del tráfico semanal a finales de 2024 al 45% para abril de 2026.
El informe de verano de 2026 de Hugging Face examinó el tamaño de los modelos. En casi todos los meses de 2026, el modelo abierto más grande publicado por un laboratorio chino fue mayor que cualquier modelo de un laboratorio estadounidense. El techo mensual de China osciló entre 754.000 millones y 2,78 billones de parámetros, mientras que los modelos de EE. UU. se mantuvieron por debajo de 130.000 millones de parámetros en cinco de los siete meses. AMD y NVIDIA publicaron cada una más de 200 nuevos repositorios de modelos en 2026 —más que cualquier otra organización—, con LiquidAI en tercer lugar con alrededor de 100.
Estadísticas de uso de tokens para modelos abiertos
Las descargas miden con qué frecuencia se copian los pesos; los tokens miden cuánto trabajo realiza un modelo. OpenRouter y a16z analizaron más de 100 billones de tokens de tráfico real de la plataforma desde noviembre de 2024 hasta noviembre de 2025. DeepSeek sirvió 14,37 billones de tokens, por delante de Qwen con 5,59 billones y Meta Llama con 3,96 billones — orden diferente al ranking de descargas, donde Qwen lidera con un amplio margen.
Fuente: OpenRouter y a16z, State of AI, tokens enrutados en OpenRouter, noviembre de 2024 a noviembre de 2025.
Los modelos de pesos abiertos representaron aproximadamente un tercio del uso de OpenRouter para finales de 2025. En la ventana de un año, los modelos abiertos chinos promediaron el 13,0% del volumen semanal de tokens, los modelos abiertos del resto del mundo promediaron el 13,7% y los modelos propietarios del resto del mundo el 70%.
La propia serie de OpenRouter de ATOM muestra la rapidez con que pueden moverse las participaciones. DeepSeek V3 y R1 juntos llegaron a representar hasta el 75,6% de los tokens de inferencia de modelos abiertos en junio de 2025, cayendo al 31,1% para enero de 2026. La participación de Meta cayó desde un pico del 37,4% en enero de 2025 a cero en agosto de 2025. El liderazgo en esta medida puede cambiar en cuestión de meses.
Presenc AI, utilizando una combinación diferente de fuentes, reporta una participación abierta menor: alrededor del 15% de los tokens de inferencia en enero de 2026, frente a alrededor del 1% un año antes. Dentro de esa estimación, DeepSeek posee alrededor del 6%, Qwen alrededor del 5% y Llama alrededor del 3%.
IA de código abierto vs IA cerrada: uso, ingresos y rendimiento
Mozilla publicó su primer informe State of Open Source AI en julio de 2026. Encontró que los modelos abiertos gestionan alrededor del 33% del uso activo de IA pero capturan cerca del 4% de los ingresos globales de IA; los modelos cerrados representan el 67% restante del uso y el 96% de los ingresos. La divergencia se deriva de cómo ganan dinero los modelos abiertos: nadie paga una tarifa de licencia por token para ejecutar pesos abiertos, por lo que los ingresos fluyen a quien aloja el modelo —a menudo la propia infraestructura del comprador.
Otras fuentes reportan una participación de uso menor. MIT Sloan, citado por TechnologyChecker, sitúa a los modelos cerrados en aproximadamente el 80% del uso de modelos y dice que los modelos abiertos alcanzan cerca del 90% del rendimiento de los modelos cerrados al momento de su lanzamiento.
La brecha de rendimiento ha cambiado con el tiempo. El seguimiento de Chatbot Arena de Mozilla muestra que la brecha promedio cayó de aproximadamente 8,04% a tan solo 0,5% para agosto de 2024. Luego se amplió tras el lanzamiento de nuevos modelos de razonamiento por parte de laboratorios cerrados, situándose en 3,3 puntos porcentuales en marzo de 2026.
BenchLM usa una escala diferente. Al 20 de octubre de 2026, 12 de sus 50 mejores modelos (24%) eran de pesos abiertos, al igual que 494 de los 972 modelos que rastrea (51%). Su mejor modelo abierto, MiMo-V2.6-Pro de Xiaomi, obtuvo 73,66 sobre 100 y se ubicó en el puesto 12 —13,03 puntos detrás del mejor modelo propietario, Claude Opus 5.5. BenchLM lista la brecha de Arena Elo entre el mejor modelo cerrado y el mejor modelo abierto en 36,8 puntos al 15 de octubre de 2026, frente a 29,2 puntos aproximadamente un año antes. La página describe esto como una reducción, pero las cifras tal como están impresas muestran una brecha mayor, por lo que la tendencia debe leerse con cuidado.
La brecha también depende de la tarea. La comparación de mayo de 2026 de Presenc AI muestra una paridad casi total en pruebas de conocimiento y programación, y una amplia ventaja para los modelos cerrados en pruebas de razonamiento difíciles.
Fuente: Presenc AI, Open Source vs Closed AI Market Share 2026. Los valores son aproximados.
Los resultados individuales pueden romper el patrón. GLM-5.2 de Z.ai obtuvo 81,0 en Terminal-Bench 2.1 frente a 83,4 de GPT-5.5, y en SWE-bench Pro obtuvo 62,1 frente a 58,6 de GPT-5.5. El propio conjunto de datos de Mozilla tenía al mejor modelo abierto en 67,9 en Terminal-Bench 2.1 antes de la llegada de GLM5.2 —los datos del informe ya estaban desactualizados respecto al lanzamiento más reciente el día de su publicación.
Estadísticas de adopción de desarrolladores y uso en producción
El informe de Mozilla se basa en una encuesta de SlashData a 1.494 desarrolladores, realizada en mayo de 2026, entre desarrolladores que agregan funciones de IA a aplicaciones.
Fuente: encuesta de desarrolladores de Mozilla y SlashData 2026, realizada en mayo de 2026. Las primeras dos filas se superponen.
La producción es donde los dos grupos divergen. Entre los equipos que trabajan con modelos abiertos, el 51% llega a producción, en comparación con el 63% de los modelos cerrados. La página del informe de Mozilla lista la cifra abierta como 53%, mientras que su entrada de blog indica el 51%. Alvaro Ruiz Cubero, de SlashData, atribuye la brecha a la falta de infraestructura más que a la calidad del modelo.
Cuando se preguntó qué bloquea los proyectos de modelos abiertos, los desarrolladores citaron con mayor frecuencia el costo de infraestructura con un 27%, seguido de seguridad y cumplimiento con un 26%, mantenimiento y actualizaciones con un 24% y complejidad de despliegue con un 23%. Las cuatro respuestas tienen pesos cercanos, por lo que ninguna solución única resuelve el problema.
El uso también depende del trabajo. Presenc AI estima que alrededor del 94% del trabajo de borde y en dispositivos usa un modelo abierto, con participaciones de aproximadamente el 85% para trabajo de alto volumen sensible a costos y cerca del 71% para trabajo con datos sensibles en campos como derecho, finanzas y salud.
Fuente: Presenc AI, Open Source vs Closed AI Market Share 2026.
Los resultados de las encuestas dependen de cómo se formule la pregunta. Presenc AI dice que alrededor del 89% de las empresas usan al menos un modelo de código abierto en producción, mientras que la Linux Foundation, citada por TechnologyChecker, encontró que el 63% de las organizaciones usan IA de código abierto y el 89% usan algún componente de código abierto en su stack de IA.
El despliegue visible en la web es mucho menor. TechnologyChecker escaneó más de 50 millones de dominios en mayo de 2026 y encontró que Botpress, el framework de IA de código abierto más común que pudo detectar, se ejecutaba en 1.558 dominios —frente a 52.682 para la API cerrada de OpenAI y 1.349 para Dialogflow de Google. De las 899 empresas vinculadas a un despliegue de Botpress, el 64% tenía 10 empleados o menos, el 81% tenía menos de 50 y alrededor del 5% tenía 1.000 o más. Estados Unidos representó cerca del 23% de los despliegues detectados, seguido de España con el 6,9% e India con el 6%. TechnologyChecker señala que su método no puede ver herramientas de backend como transformers, LangChain u Ollama; sus conteos reflejan solo la capa visible en el navegador.
Estadísticas del ecosistema de Hugging Face
El informe de primavera de 2026 de Hugging Face dijo que la plataforma creció a 13 millones de usuarios, más de 2 millones de modelos públicos y más de 500.000 conjuntos de datos públicos en 2025. Su informe de verano, que cubre de enero a agosto de 2026, registró que los repositorios públicos de modelos aumentaron de 2,43 millones a 2,96 millones, los conjuntos de datos de 711.000 a 1 millón y los Spaces de 1,00 millón a 1,44 millones.
La atención está muy concentrada. El informe de primavera encontró que cerca de la mitad de todos los modelos tenían menos de 200 descargas totales, y que los 200 mejores modelos —el 0,01% del total— concentraban el 49,6% de todas las descargas. El informe de verano situó la participación de modelos con menos de 200 descargas de por vida en 85,6%, y dijo que el 1,5% de los repositorios representa el 99,2% de las desc. Los dos informes cuentan de manera diferente y cubren períodos distintos, pero ambos muestran la misma forma: un pequeño grupo de modelos captura casi todo el tráfico.
El Stanford AI Index 2026 cuenta alrededor de 5,6 millones de proyectos relacionados con IA en GitHub y Hugging Face, de los cuales solo 206.880 (3,7%) tienen 10 estrellas o más. Las subidas de modelos en Hugging Face se más que triplicaron entre 2023 y 2025, alcanzando 332.000 en un solo trimestre.
Fuente: Hugging Face, State of Open Source on Hugging Face: Spring 2026, publicado el 17 de marzo de 2026.
La media ha crecido mucho más rápido que la mediana. Hugging Face atribuye a la cuantización y los diseños de mezcla de expertos el impulso del extremo superior, mientras que el uso de modelos pequeños se mantiene plano. Los modelos pequeños aún concentran la mayoría de las descargas: los modelos de menos de 1.000 millones de parámetros representan el 83% de las descargas de todos los tiempos y los de más de 100.000 millones el 1%, mientras que solo para las descargas de 2026, el 3% fue a modelos de más de 70.000 millones de parámetros.
Los likes y las descargas miden cosas distintas. Los 25 mejores repositorios por descargas de 2026 y los 25 mejores por likes compartieron exactamente una entrada. El modelo all-MiniLM-L6-v2 fue descargado 1.550 millones de veces en siete meses y tiene 5.156 likes.
Qwen se ha convertido en la base sobre la que otros construyen. Los modelos basados en Qwen representan 151.448 derivados en el Hub —2,6 veces el total de Meta y 4,7 veces solo los repositorios de Llama—, con Google en segundo lugar con 82.506. Los derivados de Qwen crecieron a un ritmo de aproximadamente 180 a 210 nuevos repositorios por día en los primeros siete meses de 2026.
La ejecución local sigue el mismo patrón. Qwen registra 39,6 millones de descargas GGUF al mes, frente a 20,8 millones de Gemma y 7,5 millones de Llama. GGUF es el formato de archivo utilizado por ejecutores locales como llama.cpp.
El crecimiento más rápido se encuentra en la capa de ejecución. Los repositorios que usan la librería gguf crecieron 464%, lerobot 194% y mlx de Apple 148%, mientras que transformers y peft crecieron 16% y diffusers 21%. Todos los repositorios de modelos crecieron 21,5%.
Los agentes han surgido como una nueva clase de usuario. Claude Code representó el 44,4% del tráfico etiquetado como agente hacia el Hub en julio de 2026, frente al 67,8% de abril, mientras que Codex subió del 10,4% al 20,8% en los mismos meses.
Estadísticas de costos, precios y financiamiento
Mozilla reporta que la inferencia de clase GPT-4 cayó de unos $20 a aproximadamente $0,40 por millón de tokens en 36 meses —una caída de 50 veces que el informe vincula a la competencia de los pesos abiertos. Un análisis de la Linux Foundation citado en el informe sitúa la inferencia de modelos cerrados en alrededor de seis veces el costo de un modelo abierto comparable. Mozilla convierte esa brecha en una estimación de $24.800 millones en ahorros anuales no realizados si los compradores trasladaran las cargas de trabajo elegibles a pesos abiertos. Como ejemplo, Stripe redujo sus costos de inferencia en un 73% mientras gestionaba 50 millones de llamadas diarias a la API al mover parte de su trabajo de IA a modelos abiertos.
Las listas de precios de proveedores ilustran la dispersión. La comparación de mayo de 2026 de Presenc AI lista a DeepSeek V4 en $0,14 por millón de tokens de entrada, frente a $3,00 para GPT-5.5 y Claude 4.7 Opus.
Fuente: Presenc AI, Open Source vs AI Market Share 2026, precios de proveedores de mayo de 2026.
Los modelos cerrados más pequeños se sitúan cerca de los precios abiertos, con GPT-5.5 mini listado en $0,15 y Gemini 3.1 Flash en $0,075 —en los niveles inferiores, el precio por sí solo no separa lo abierto de lo cerrado.
Las empresas construidas sobre modelos abiertos están comenzando a reportar ingresos. El informe de Mozilla lista a Databricks con una tasa anualizada de $5.400 millones y Mistral AI con alrededor de $400 millones de ingresos recurrentes anuales, un aumento de 20 veces en doce meses. DeepSeek está en alrededor de $220 millones y ha recaudado $7.400 millones con una valoración superior a $50.000 millones. Mistral anunció una Serie C de 1.700 millones de euros el 9 de septiembre de 2025 con una valoración post-money de 11.700 millones de euros, liderada por ASML. Zhipu AI y MiniMax están ambas buscando cotizaciones en Hong Kong en 2026. En mayo de 2026, IBM y Red Hat comprometieron $5.000 millones para herramientas e infraestructura de IA de código abierto. Market.us proyecta que el mercado de modelos de IA de código abierto crecerá de $19.050 millones en 2025 a $23.080 millones en 2026, cerca del 21%.
Las licencias indican de dónde no proviene el retorno. De los 178 lanzamientos chinos de más de 20.000 millones de parámetros en 2026, el 59% usa Apache 2.0 y el 22% usa MIT. Para los lanzamientos estadounidenses en la misma banda de tamaño, el 29% usa Apache o MIT, el 41% usa términos personalizados y el 30% no declara nada. Hugging Face señala que algunos de los lanzamientos más grandes recientes, como Kimi K3 y Qwen 3.8 2.4T, han comenzado a agregar límites no comerciales o términos de participación en ingresos —el panorama de licencias está cambiando.
Fuentes
- The ATOM Report (arXiv)
- OpenRouter, State of AI
- Hugging Face, State of Open Source on Hugging Face: Spring 2026
- State of Open Source AI (Mozilla)
- BenchLM, Open Source LLM Statistics (2026)
- Hugging Face, State of Open Models: Summer 2026 Observations
- TechnologyChecker, Open-Source AI Adoption 2026
- Tech Insider, Open-Source AI Powers 33% of Use, Just 4% of Revenue
- Presenc AI, Open Source vs Closed AI Market Share 2026
- Command Linux, Open-Source AI Model Download Statistics 2026
Este artículo fue publicado originalmente en Blockonomi.

