El Departamento de Justicia de EE. UU. respalda la posición de fair use de OpenAI y advierte que el licenciamiento podría crear una oligopolio de IA
Puntos clave
- •El Departamento de Justicia presentó un escrito de interés argumentando que el uso de textos protegidos por derechos de autor en el entrenamiento de modelos de OpenAI debería estar amparado por el fair use.
- •El gobierno advirtió que el licenciamiento obligatorio de textos de entrenamiento elevaría las barreras de entrada, favoreciendo a las corporaciones ricas y a las editoriales establecidas mientras margina a los desarrolladores más pequeños.
- •El escrito no ofrece protección total: distingue el entrenamiento de los resultados que reproducen material protegido y de la forma en que se obtienen los datos de entrenamiento.
- •The New York Times y Mary Rasenberger, directora del Authors Guild, criticaron la postura del gobierno, mientras que el juez Sidney Stein puede desestimarla libremente.
- •Goldman Sachs Research proyecta que la inversión mundial relacionada con la IA superará el billón de dólares en 2026, incluidos 581.000 millones de dólares en Estados Unidos.
El Departamento de Justicia de Estados Unidos informó el martes a un tribunal federal de Manhattan que el uso de textos protegidos por derechos de autor durante el entrenamiento de modelos de OpenAI debería estar amparado por el fair use, una posición que podría reconfigurar la economía de la industria mundial de la IA, en un año en que la inversión global está encaminada a superar el billón de dólares.
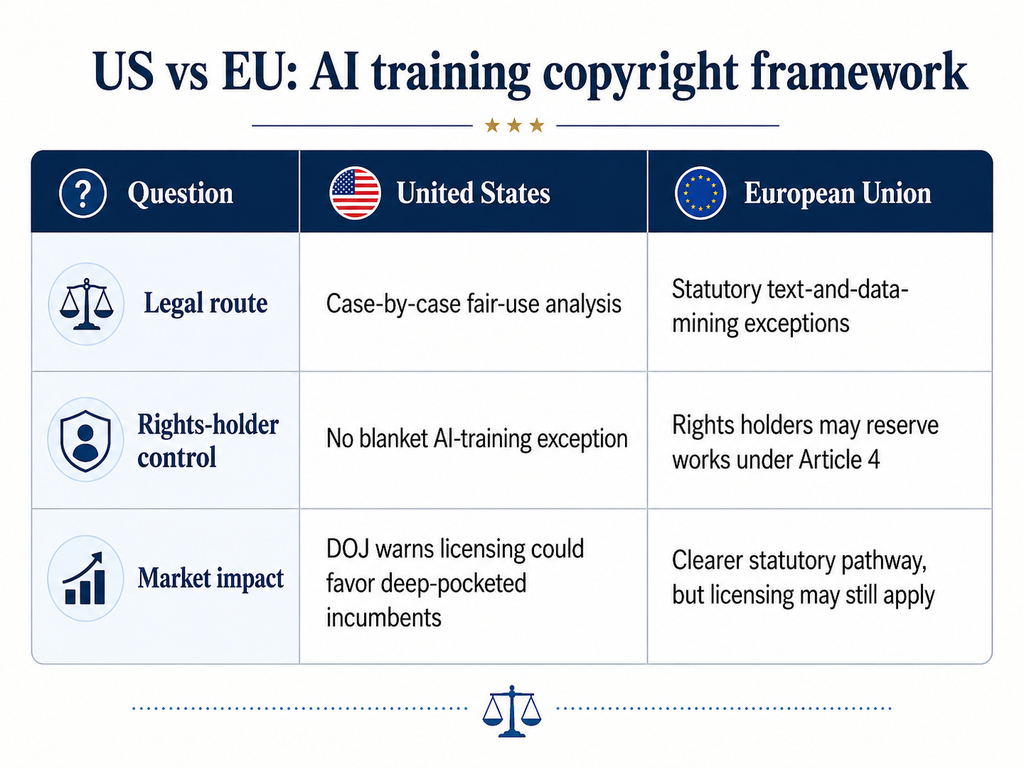
En un escrito de interés presentado en la demanda consolidada de derechos de autor contra OpenAI, el gobierno advirtió que si a los desarrolladores se les exigiera licenciar los textos de entrenamiento, solo las corporaciones más ricas podrían seguir construyendo tecnologías de IA de vanguardia.
El gobierno planteó su argumento tanto en términos legales como económicos: el licenciamiento obligatorio podría crear grandes obstáculos para entrar al mercado, fortalecer a las empresas tecnológicas consolidadas y transferir gran parte de las ganancias resultantes a las editoriales establecidas que poseen los archivos más grandes.
Escritos de interés como este no deciden el caso; permiten que el gobierno federal señale su postura sobre asuntos pendientes ante un tribunal, y los jueces siguen siendo libres de sopesarlos o desestimarlos.
Por qué Washington considera que un régimen de licencias es una barrera de entrada
Según el Departamento de Justicia, imponer un costo sobre la información utilizada para entrenar la IA podría marginar a los desarrolladores más pequeños en favor de los actores más grandes. Esto coincide con un informe de la OCDE que concluye que el acceso a la capacidad de cómputo, los datos y la experiencia en el mercado actual de la IA ya está consolidado y seguirá favoreciendo a las empresas bien establecidas.
Washington también argumentó que los creadores más pequeños se benefician de herramientas de IA de bajo costo. Los autores, en particular, pueden usar los modelos para generar imágenes que de otro modo no podrían costear, o para encontrar fuentes y perspectivas que de otra manera pasarían por alto.
Sin embargo, la Oficina de Derechos de Autor de EE. UU. ha asumido una postura más matizada, señalando en su propio informe sobre el entrenamiento de IA generativa que algunos usos de entrenamiento podrían estar cubiertos por el fair use mientras que otros no, según la fuente del material, el propósito de su uso y el impacto en el mercado.
El argumento del uso transformador en el centro del debate
El Departamento de Justicia se apoyó en gran medida en el primer factor del fair use, describiendo el entrenamiento de la IA como "extraordinariamente transformador". Bajo la ley de derechos de autor de EE. UU., el fair use se evalúa sopesando varios factores legales, incluidos el propósito y carácter del uso, la naturaleza de la obra, la cantidad utilizada y el efecto sobre el mercado de la obra original. El gobierno argumentó que las copias de entrenamiento cumplen un propósito distinto al de los artículos originales y que los beneficios de la IA "superan con creces cualquier daño competitivo".
No obstante, el escrito no otorga protección total a los desarrolladores de IA. Distingue entre el entrenamiento de modelos y los resultados que reproducen material protegido por derechos de autor, así como las cuestiones sobre cómo se obtienen los datos de entrenamiento.
Esa distinción se observa en los casos de California. Un análisis de la Copyright Alliance sobre Bartz v. Anthropic y Kadrey v. Meta señala que ambos tribunales fallaron que el entrenamiento era transformador, pero llegaron a conclusiones distintas sobre la piratería y el daño al mercado.
El fiscal general adjunto Stanley Woodward Jr. calificó el escrito como una "declaración de interés histórica", vinculando la postura de la administración en materia de derechos de autor con el objetivo más amplio de mantener la posición de EE. UU. en la IA.
Seguridad nacional y la carrera contra rivales extranjeros
El escrito también presenta las reglas de derechos de autor como un asunto de política industrial y seguridad nacional, argumentando que mayores costos de desarrollo podrían dejar en desventaja a las empresas de EE. UU. frente a competidores extranjeros.
Lo que está en juego es considerable. Goldman Sachs Research proyecta más de un billón de dólares en inversión mundial relacionada con la IA en 2026, incluidos 581.000 millones de dólares en Estados Unidos.
La Unión Europea ha tomado un camino distinto. Su Directiva del Mercado Único Digital establece excepciones explícitas para la minería de texto y datos, aunque los titulares de derechos pueden excluir sus obras de ciertas formas de minería. Por lo tanto, una resolución de EE. UU. sobre el fair use se produciría en un contexto en el que los dos mayores mercados occidentales del mundo ya han divergido en cómo regulan los datos de entrenamiento de IA.
Qué dicen las editoriales y el tribunal a continuación
The New York Times, que demandó a OpenAI y Microsoft en 2023, rechazó la postura de Washington.
Mary Rasenberger, directora ejecutiva del Authors Guild, fue igualmente crítica y dijo a WIRED que el escrito estaba "lleno de argumentos defectuosos y de una grave incomprensión de la doctrina de fair use y del derecho de autor".
La académica de derechos de autor de Berkeley Pamela Samuelson describió la intervención del gobierno con más cautela, calificándola de "un desarrollo significativo".
El juez Sidney H. Stein, quien preside el caso, no está obligado a seguir la posición del Departamento de Justicia.
Un fallo favorable a OpenAI aún podría dejar sin resolver una cuestión crucial: cómo se obtienen los datos de entrenamiento. Como señaló Cryptopolitan, el acuerdo de 1.500 millones de dólares entre Anthropic y los autores se refirió a copias piratas del material de entrenamiento, no al acto de entrenar en sí.
Esa diferencia puede ser muy importante. Incluso si el entrenamiento se considera fair use, los desarrolladores de IA todavía enfrentan un riesgo legal significativo por obtener ilegalmente el material utilizado para construir sus modelos.

