ChatGPT Images 2.5 vs. Nano Banana 2: Comparación en seis categorías
Puntos clave
- •ChatGPT Images 2.5 empató con Nano Banana 2, con tres victorias por categoría para cada modelo.
- •OpenAI afirma que el nuevo modelo puede reducir hasta 50% la latencia de generación de imágenes frente a Images 2.0.
- •La prueba determinó que ChatGPT Images 2.5 ya no mostraba la dominante amarilla ni el sobreenfoque intenso de generaciones anteriores.
- •Nano Banana 2 ganó las pruebas de texto denso y la cronología de Bitcoin después de que ChatGPT Images 2.5 cometiera errores ortográficos y de fechas.
- •OpenAI añadió Sketch, intercambio de indicaciones, comentarios regionales, plantillas de formato y nuevos niveles de calidad high y max para la API.
OpenAI lanzó ChatGPT Images 2.5 el 8 de septiembre, prometiendo mayor nitidez, texturas más ricas, iluminación más natural, edición más precisa y hasta 50% menos latencia en la generación de imágenes que Images 2.0.
En una comparación de seis categorías, Nano Banana 2 ganó tres pruebas y ChatGPT Images 2.5 ganó las otras tres. Los resultados se diferenciaron menos por diferencias evidentes de calidad que por pequeños errores comprobables, incluido un error ortográfico y una fecha incorrecta en una infografía basada en investigación.
OpenAI afirma que la latencia disminuyó hasta 50% frente a Images 2.0. La compañía también añadió dos modelos a la API: GPT-Image-2.5 Flare, la opción rápida predeterminada, y GPT-Image-2.5 Sunburst, diseñado para ofrecer precisión de edición premium.
La comparación sigue a una prueba anterior publicada en mayo, cuando GPT Image 2 y Nano Banana 2 se repartieron las victorias en ocho categorías. GPT Image 2 ganó más categorías, pero desarrollaba un artefacto distintivo de sobreenfoque cuando las indicaciones incluían muchas restricciones simultáneas. Eso planteó una pregunta para el siguiente modelo: ¿podría OpenAI solucionar el problema?
Para esta ronda, el mismo evaluador utilizó seis categorías tomadas o adaptadas de las pruebas anteriores y envió las mismas indicaciones a ambos modelos. El modelo de Google fue Nano Banana 2, el nombre que la compañía utiliza para Gemini 3.1 Flash Image, en lugar del más lento y deliberado Nano Banana Pro. Por lo tanto, la prueba comparó el nuevo modelo rápido y enfocado en la precisión de OpenAI con la oferta equivalente de Google.
Qué cambió en GPT-Image-2.5
Los modelos de imágenes de OpenAI ya habían sido asociados con defectos distintivos. El modelo detrás del GPT Image 1 original desarrolló una dominante cálida y amarilla persistente que los usuarios apodaron el “filtro de pis”. OpenAI nunca explicó ni corrigió por completo ese matiz.
GPT Image 2 reemplazó ese problema por otro: las indicaciones con demasiadas restricciones acumuladas podían producir imágenes excesivamente sobreenfocadas, llenas de artefactos ásperos y sobreprocesados.
Ninguno de los dos problemas apareció en esta prueba. Las imágenes generadas con ChatGPT Images 2.5 mantuvieron su equilibrio de color y detalle incluso con indicaciones de máxima complejidad. La dominante amarilla y el sobreenfoque excesivo observados en las dos generaciones anteriores estuvieron ausentes. La mejora fue especialmente evidente en las pruebas steampunk y de retrato, que produjeron las imágenes de ChatGPT con mayor coherencia fotográfica entre las tres generaciones evaluadas.
OpenAI también introdujo funciones de flujo de trabajo que no quedan reflejadas en una simple comparación de imagen contra imagen. Sketch permite a los usuarios dibujar directamente en ChatGPT un diseño aproximado que sirve como referencia para la generación. Entre las demás novedades están compartir indicaciones, comentarios dentro de la imagen sobre regiones específicas y plantillas de formato para carteles y productos. En la API, los niveles de calidad ahora van desde low hasta las nuevas configuraciones high y max, por encima del límite de Images 2.0.
Así rindieron los dos modelos en las seis categorías.
Densidad de texto: la escena de Kellerman’s Hardware
La primera prueba mostraba una intersección áspera a las 2 a. m., en la que casi todas las superficies contenían texto legible: un letrero fantasma, grafiti pintado con aerosol, letras vinílicas de una tienda, un cartel de concierto rasgado, una banqueta con esténcil y un teléfono público cubierto de calcomanías.
Nano Banana 2 representó casi todo el texto con claridad. Su principal error fue una calcomanía del teléfono público que repetía su propio texto de forma confusa, un defecto menor que podía pasar fácilmente inadvertido.
ChatGPT Images 2.5 incluyó un detalle que Nano Banana 2 omitió: un poste de luz cubierto de volantes superpuestos y engrapados, rasgados y desgastados tal como indicaba la instrucción. Sin embargo, su etiqueta de arte callejero parecía decir “STILLL HERE”, con una L adicional. El apóstrofo de “KELLERMAN’S” en el letrero fantasma también faltaba o era ilegible.
Aunque OpenAI produjo la escena más realista en general, cometió dos errores distintos de legibilidad en una prueba centrada en la representación precisa de texto. Nano Banana 2 ganó la categoría.
Ganador: Nano Banana 2
Conciencia espacial: la torre del reloj steampunk
Esta prueba de composición aérea requería una escena con cinco planos de profundidad y una enorme torre de reloj. Sus esferas debían mostrar horas diferentes mediante números romanos legibles, mientras que otros seis elementos de texto se distribuían desde el primer plano hasta el fondo.
ChatGPT Images 2.5 creó una imagen claramente más atmosférica. El vapor se elevaba de forma visible desde los tejados, un río atravesaba el plano medio y el rango tonal era más rico en los cinco planos de profundidad. El texto también era más fácil de leer.
Nano Banana 2 produjo una atmósfera más plana. Sus dos esferas visibles sí contenían números romanos legibles —XII, III, VI y IX—, pero las manecillas estaban colocadas de forma similar en ambos relojes, en contra de la solicitud de la indicación de mostrar horas diferentes.
ChatGPT Images 2.5 ganó por seguir mejor las instrucciones sin sacrificar el realismo.
Ganador: ChatGPT Images 2.5
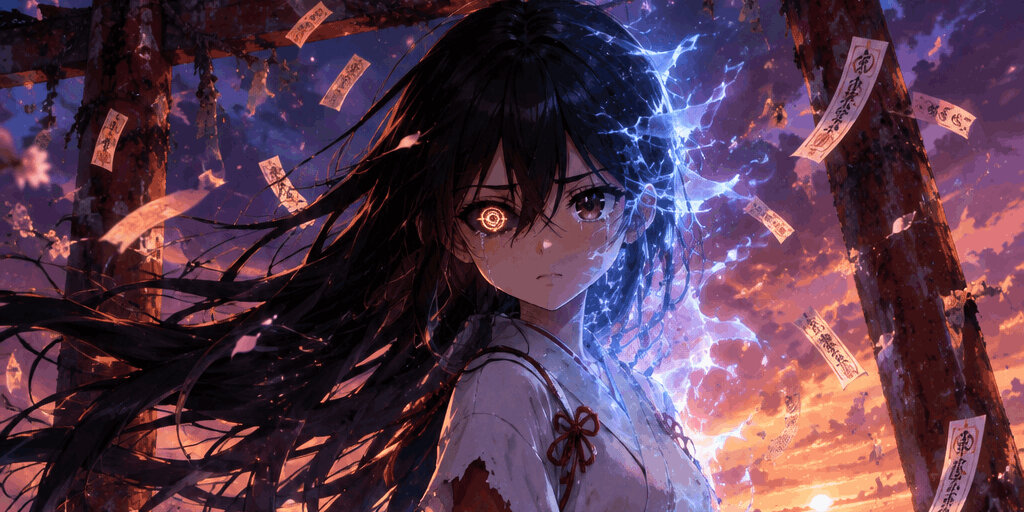
Ilustración: la médium espiritual de anime
La indicación pedía una imagen principal con estilo de Studio Ufotable que mostrara a una chica transformándose en energía espiritual en un torii, acompañada por un zorro kitsune de nueve colas bajo un cielo crepuscular pintado con el estilo asociado a Makoto Shinkai.
ChatGPT Images 2.5 produjo el cielo más logrado de toda la serie de pruebas. Incluyó un disco solar visible, un reflejo en el agua y una silueta montañosa que respaldaba la comparación con Shinkai. Los ojos asimétricos del personaje también funcionaron bien.
El modelo fue menos literal con la instrucción de que la chica debía estar “disolviéndose en energía”. Reinterpretó la idea como un efecto de chispas eléctricas recorriendo su cabello, en lugar de la disolución fluida y translúcida descrita en la indicación. El rastro de energía azul y blanca de Nano Banana 2 coincidió mejor con esa instrucción específica.
Ninguno de los dos modelos creó un zorro de nueve colas convincente. Aun así, ChatGPT Images 2.5 ganó por su impacto visual general.
Ganador: ChatGPT Images 2.5
Realismo: la arquitecta en la azotea
Este retrato cinematográfico incluía numerosas restricciones independientes: gabardina beige, lentes redondos, planos sostenidos específicamente con la mano izquierda, iluminación de hora dorada, poca profundidad de campo y grano de película.
ChatGPT Images 2.5 produjo una iluminación destacada, con el disco solar directamente detrás de la protagonista y una excelente microtextura de piel. La piel era demasiado suave, pero el entorno se veía muy realista, similar a una fotografía tomada con una cámara analógica.
Añadir instrucciones que normalmente reducirían la calidad fotográfica aumentó inesperadamente el realismo de la imagen. Una generación utilizó palabras clave como “realista, luces altas, sombras aplastadas, flash irregular, tonos de piel quemados, momento espontáneo, tomada con la cámara de un teléfono”.
Nano Banana 2 conservó una composición más completa y colocó los planos en la mano derecha de la protagonista, en lugar de la izquierda solicitada. Sin embargo, añadió una etiqueta legible al plano: “PROJECT: 124 DUANE ST”, un detalle que la mayoría de las generaciones omitió.
Nano Banana 2 ganó la comparación de una sola imagen, mientras que ChatGPT Images 2.5 fue considerado superior en iteraciones repetidas.
Ganador: Nano Banana 2 en una sola toma; ChatGPT Images 2.5 en iteraciones repetidas
Investigación agéntica: la cronología de Bitcoin
Ambas plataformas pueden investigar un tema antes de generar una imagen. La prueba pidió una cronología panorámica de la historia de Bitcoin, con estilo de dibujo infantil y un requisito estricto de precisión factual. Fue la categoría más importante de la comparación y produjo la mayor diferencia entre los modelos.
ChatGPT Images 2.5 generó una infografía limpia de dos filas con numerosas fechas específicas, pero una era incorrecta. Identificó 2023 como el año en que se aprobaron los fondos cotizados en bolsa de Bitcoin en Estados Unidos. La Comisión de Bolsa y Valores de Estados Unidos aprobó los primeros ETF spot de Bitcoin el 10 de enero de 2024, un año completo después. La fuente señaló que la discrepancia podría reflejar un problema de interpretación, ya que los ETF de futuros fueron aprobados ese año.
Nano Banana 2 produjo una cronología menos estructurada con eventos similares. Su resultado utilizó el rango “2023–2024” para la aprobación de los ETF y el cuarto halving, en lugar de afirmar un solo año incorrecto. Por ello, ninguna de sus fechas era técnicamente falsa.
Nano Banana 2 ganó porque una fecha incorrecta expresada con seguridad tiene mayor importancia en una prueba diseñada para evaluar si el “razonamiento agéntico” produce investigaciones precisas.
Ganador: Nano Banana 2
Conceptos abstractos: una indicación con palabras inventadas
La indicación final estaba compuesta casi por completo por términos inventados: “A woman eating shmfiyxl in Lyxin. Next to her, her Lymglsushing plays Lakishkark.” El platillo, el lugar, el acompañante y la actividad no tenían definiciones de diccionario, por lo que cada modelo tuvo que inventar sus significados y decidir cómo representarlos.
ChatGPT Images 2.5 incorporó las palabras sin sentido directamente en la escena como texto visible. “Lyxin” aparecía en un letrero de neón sobre un restaurante elegante y futurista, mientras que “Lakishkark” estaba impreso en la caja de un juego de mesa que jugaba el acompañante alienígena de la mujer. Al convertir los términos inventados en letreros legibles, el modelo los hizo concretos en lugar de abstractos.
Nano Banana 2 adoptó un enfoque diferente. Generó una escena cálida y culturalmente específica con un puesto de mercado guatemalteco, una mujer con un huipil tradicional y una criatura parecida a un orco que tocaba un instrumento híbrido de cuerdas y tubos. Interpretó “plays” como tocar música en vez de jugar un juego, una lectura diferente pero válida de la indicación.
Sin embargo, nada en la imagen hacía referencia específicamente a “Lyxin” o “Lakishkark”, y ninguna de las dos palabras inventadas apareció como texto visible. ChatGPT Images 2.5 ganó porque convertir conceptos indefinidos en etiquetas legibles fue la respuesta más literal a una indicación que no proporcionaba significados establecidos.
Ganador: ChatGPT Images 2.5
El veredicto
Nano Banana 2 ganó tres de las seis categorías, por lo que la comparación terminó efectivamente empatada. El resultado depende de las expectativas del usuario y de cómo se utilice el modelo.
ChatGPT Images 2.5 corrigió el problema de sobreenfoque que afectaba a su predecesor. Su resultado de ilustración fue posiblemente la imagen individual más impactante visualmente producida por cualquiera de los dos modelos durante las dos rondas completas de pruebas.
La elección del modelo depende, por lo tanto, de la tarea: las imágenes con mucho texto y basadas en investigación dan mayor peso a la legibilidad exacta y la verificación factual, mientras que la ilustración y los flujos de generación repetida destacan fortalezas diferentes observadas en esta prueba. La comparación no establece un ganador universal, pero sí muestra por qué evaluar modelos de imágenes requiere algo más que juzgar una sola imagen por su atractivo visual.
La principal diferencia no fue la calidad general, sino una serie de pequeños detalles verificables: un error ortográfico en una escena cargada de texto, un año incorrecto en una infografía basada en investigación y otros fallos puntuales al seguir instrucciones. En estética general y calidad de imagen, ambos modelos fueron ampliamente comparables.

