Open-Source-KI-Modelle 2026: Die Zahlen zu Downloads, Nutzung und Verbreitung
Wichtige Erkenntnisse
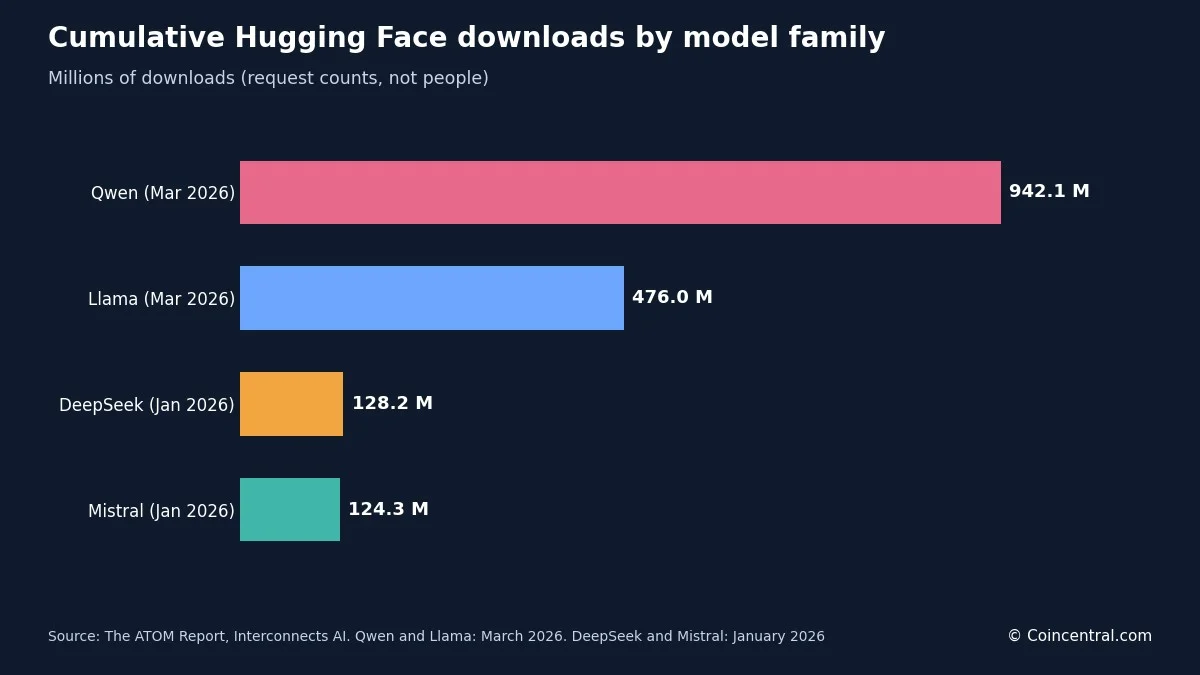
- •Alibabas Qwen hatte bis März 2026 kumuliert 942,1 Millionen Hugging-Face-Downloads erreicht, rund doppelt so viele wie Metas Llama mit 476,0 Millionen.
- •Laut Mozilla bewältigen offene Modelle etwa 33 % der aktiven KI-Nutzung, erzielen aber nur rund 4 % der weltweiten KI-Umsätze.
- •Chinas offene Modelle überholten die Vereinigten Staaten Ende Juli 2025 bei den kumulierten Downloads und führten im März 2026 mit 428 Millionen.
- •Nur 51 % der Teams mit offenen Modellen erreichen die Produktion, gegenüber 63 % bei geschlossenen Modellen; die Lücke wird hauptsächlich auf fehlende Infrastruktur und nicht auf die Modellqualität zurückgeführt.
- •Die Inferenzkosten für Modelle der GPT-4-Klasse sanken über 36 Monate um etwa das 50-Fache, von rund 20 $ auf 0,40 $ pro Million Token – ein Rückgang, den der Bericht mit dem Open-Weight-Wettbewerb verbindet.
Open-Source-KI-Modelle sind heute fester Bestandteil der Softwareentwicklung. Entwickler laden sie herunter, bauen Anwendungen darauf auf und betreiben sie auf eigener Hardware. Mehrere Organisationen versuchen, diese Aktivität zu messen, doch ihre Zahlen stimmen nicht immer überein. Dieser Bericht stellt die wichtigsten Kennzahlen gegenüber und behandelt Downloads, Token-Nutzung, regionale Verschiebungen, Kosten, Entwicklerumfragen und Unternehmensfinanzierungen. Jede Zahl ist mit ihrer Quelle, ihrem Datum und einem Hinweis versehen, was sie tatsächlich misst.
Ein Vorbehalt gilt für alle unten genannten Metriken: Ein Download ist eine Dateianfrage, keine Person. Eine Token-Zählung misst die geleistete Arbeit, nicht die erstellten Kopien. Die meisten offenen Modelle werden zutreffender als Open-Weight-Modelle bezeichnet: Die trainierten Parameter sind öffentlich, die Trainingsdaten und der Code hingegen oft nicht. Die Zahlen beschreiben daher unterschiedliche Ebenen der Verbreitung: Distribution, Inferenz, Experimente und Produktiveinsatz. Sie sollten gemeinsam betrachtet und nicht als austauschbare Kennzahlen für Marktanteile verstanden werden.
Die wichtigsten Zahlen im Überblick:
- Qwen hatte bis März 2026 kumuliert 942,1 Millionen Hugging-Face-Downloads erreicht; Llama kam auf 476,0 Millionen.
- DeepSeek lieferte zwischen November 2024 und November 2025 14,37 Billionen Token über OpenRouter aus.
- Open-Modelle bewältigen laut Mozilla rund 33 % der aktiven KI-Nutzung, erzielen aber nur etwa 4 % der KI-Umsätze.
- 79 % der Entwickler, die KI-Funktionen hinzufügen, nutzen offene Modelle, gegenüber 71 % für geschlossene Modelle.
- Teams mit offenen Modellen erreichen die Produktion seltener: 51 % gegenüber63 % bei geschlossenen Modellen.
Open-Source-KI-Download-Statistiken nach Modellfamilie
Der ATOM Report verfolgt rund 1.500 offene Sprachmodelle auf Hugging Face und definiert einen Download als jede HTTP-Anfrage an einen Modell-Datei-Endpunkt, einschließlich automatisierter Abrufe durch Tools wie transformers oder curl.
Alibabas Qwen-Familie hatte bis März 2026 kumuliert 942,1 Millionen Downloads erreicht, während Metas Llama-Familie im selben Monat bei 476,0 Millionen stand. Qwen überholte Llama erstmals im September 2025, als die Gesamtzahlen bei 325,4 Millionen und 323,7 Millionen lagen. Sechs Monate später hatte sich der Abstand auf 466,1 Millionen vergrößert: Qwen kam in diesem Zeitraum auf rund 617 Millionen neue Downloads, Llama auf etwa 152 Millionen.
Quelle: The ATOM Report, Interconnects AI, kumulierte Hugging-Face-Downloads.
DeepSeek und Mistral liegen deutlich hinter den beiden Spitzenreitern. DeepSeek überholte Mistral im Januar 2026 mit 128,2 Millionen Downloads gegenüber 124,3 Millionen. Zuvor hatte Mistral das Feld angeführt – ihr Anteil an neuen abgeleiteten Modellen erreichte im Dezember 2023 mit 57 % ihren Höchststand, angetrieben durch Mistral 7B und Mixtral. Metas Anteil an Derivaten erreichte im August 2024 mit 44 % seinen Höhepunkt und war bis Februar 2026 auf 11 % gefallen.
Neuere US-Labore starten von deutlich kleineren Basen. NVIDIAs Nemotron verzeichnete zwischen August 2025 und März 2026 30,7 Millionen Downloads, das Allen Institute for AI mit OLMo 14,8 Millionen und IBMs Granite 8,6 Millionen.
Unternehmensankündigungen folgen anderen Regeln. Meta teilte mit, dass Llama am 18. März 2025 die Marke von 1 Milliarde Downloads überschritten habe. Google erklärte, Gemma habe dies am 20. August 2026 erreicht, wobei ein Google-Ingenieur anmerkte, dass die Zählung Android- und Chrome-Integrationen auslässt. Keine der beiden Unternehmenszahlen wurde unabhängig geprüft, und die ATOM-Zählung für Llama erfasst nur verfolgte Textgenerierungsmodelle auf Hugging Face, sodass sich die beiden Zahlenreihen nicht direkt vergleichen lassen.
Qwens monatliches Volumen stützt seine Führung. Im Februar 2026 erzielte Qwen allein 153,6 Millionen Downloads, während die nächsten acht Open-Model-Organisationen zusammen auf 71,2 Millionen kamen.
Open-Source-KI-Download-Statistiken nach Region
ATOM ordnet jedes Modell den Vereinigten Staaten, China oder Europa anhand des Hauptsitzes der herausgebenden Organisation zu. Die insgesamt erfassten Downloads erreichten bis März 2026 2,04 Milliarden, gegenüber 339 Millionen ein Jahr zuvor.
Quelle: The ATOM Report, Interconnects AI, kumulierte Hugging-Face-Downloads.
Keine Region ging zurück. Im März 2025 führten die Vereinigten Staaten China um 80 Millionen Downloads; bis März 2026 führte China mit 428 Millionen, wobei ATOM den Überschneidungspunkt auf Ende Juli 2025 legt.
Umfragedaten weisen in dieselbe Richtung. Mozillas Entwicklerumfrage ergab eine Open-Model-Nutzung von 89 % in Großchina und Ostasien, dem höchsten Wert aller Regionen, während Westeuropa bei 70 % lag. Der OpenRouter-Traffic zeigt eine ähnliche Entwicklung: Mozillas Analyse fand, dass chinesische Open-Weight-Modelle von weniger als 2 % des Wochentraffics Ende2024 auf 45 % bis April 2026 wuchsen.
Hugging Faces Sommerbericht 2026 untersuchte die Modellgröße. In fast jedem Monat des Jahres 2026 war das größte offene Modell eines chinesischen Labors größer als jedes Modell eines US-Labors. Chinas monatliche Obergrenze lag zwischen 754 Milliarden und 2,78 Billionen Parametern, während US-Modelle in fünf von sieben Monaten unter 130 Milliarden Parametern blieben. AMD und NVIDIA veröffentlichten 2026 jeweils mehr als 200 neue Modell-Repositories – mehr als jede andere Organisation –, LiquidAI folgt mit rund 100.
Token-Nutzungsstatistiken für offene Modelle
Downloads messen, wie oft Gewichte kopiert werden; Token messen, wie viel Arbeit ein Modell verrichtet. OpenRouter und a16z analysierten mehr als 100 Billionen Token echten Plattform-Traffics von November 2024 bis November 2025. DeepSeek lieferte 14,37 Billionen Token aus, vor Qwen mit 5,59 Billionen und Meta Llama mit 3,96 Billionen – eine andere Reihenfolge als beim Download-Ranking, bei dem Qwen mit großem Abstand führt.
Quelle: OpenRouter und a16z, State of AI, über OpenRouter geroutete Token, November 2024 bis November 2025.
Open-Weight-Modelle machten bis Ende 2025 etwa ein Drittel der OpenRouter-Nutzung aus. Im Jahresverlauf erreichten chinesische offene Modelle im Durchschnitt 13,0 % des wöchentlichen Token-Volumens, offene Modelle aus dem Rest der Welt 13,7 % und proprietäre Modelle aus dem Rest der Welt 70 %.
ATOMs eigene OpenRouter-Reihe zeigt, wie schnell sich Anteile verschieben können. DeepSeek V3 und R1 machten im Juni 2025 zusammen bis zu 75,6 % der Inferenz-Token offener Modelle aus, bis Januar 2026 fielen sie auf 31,1 %. Metas Anteil sank von einem Höchststand von 37,4 % im Januar 2025 auf null bis August 2025. Die Führung bei dieser Kennzahl kann sich innerhalb weniger Monate ändern.
Presenc AI, mit einer anderen Quellenmischung, berichtet von einem geringeren offenen Anteil: etwa 15 % der Inferenz-Token im Januar 2026, gegenüber etwa 1 % ein Jahr zuvor. Innerhalb dieser Schätzung hält DeepSeek etwa 6 %, Qwen etwa 5 % und Llama etwa 3 %.
Open Source vs. Closed AI: Nutzung, Umsatz und Leistung
Mozilla veröffentlichte im Juli 2026 seinen ersten State-of-Open-Source-AI-Bericht. Darin heißt es, dass offene Modelle etwa 33 % der aktiven KI-Nutzung bewältigen, aber nur etwa 4 % der weltweiten KI-Umsätze einfangen; geschlossene Modelle entfallen auf die restlichen 67 % der Nutzung und 96 % der Umsätze. Diese Diskrepanz ergibt sich aus der Art, wie offene Modelle Geld verdienen: Niemand zahlt eine Lizenzgebühr pro Token für den Betrieb offener Gewichte, sodass die Einnahmen bei dem landen, der das Modell hostet – oft die eigene Infrastruktur des Käufers.
Andere Quellen melden einen geringeren Nutzungsanteil. Das MIT Sloan, zitiert von TechnologyChecker, setzt geschlossene Modelle bei etwa 80 % der Modellnutzung an und sagt, offene Modelle erreichen bei Veröffentlichung etwa 90 % der Leistung geschlossener Modelle.
Die Leistungslücke hat sich im Zeitverlauf verschoben. Mozillas Chatbot-Arena-Tracking zeigt einen Rückgang der durchschnittlichen Lücke von rund 8,04 % auf bis zu 0,5 % im August 2024. Nach der Veröffentlichung neuer Reason-Modelle durch geschlossene Labore weitete sie sich wieder aus und lag im März 2026 bei 3,3 Prozentpunkten.
BenchLM verwendet eine andere Skala. Stand 20. Oktober 2026 waren 12 seiner Top-50-Modelle (24 %) Open-Weight, ebenso 494 der 972 verfolgten Modelle (51 %). Sein bestes offenes Modell, Xiamis MiMo-V2.6-Pro, erzielte 73,66 von 100 Punkten und belegte Rang 12 – 13,03 Punkte hinter dem besten proprietären Modell, Claude Opus 5.5. BenchLM beziffert die Arena-Elo-Lücke zwischen dem besten geschlossenen und dem besten offenen Modell am 15. Oktober 2026 mit 36,8 Punkten, gegenüber 29,2 Punkten etwa ein Jahr zuvor. Die Seite beschreibt dies als Verkleinerung, die gedruckten Zahlen zeigen jedoch eine größere Lücke, sodass der Trend mit Vorsicht zu interpretieren ist.
Die Lücke hängt auch von der Aufgabe ab. Presenc AIs Vergleich vom Mai 2026 zeigt nahezu Parität bei Wissens- und Coding-Tests sowie einen deutlichen Vorsprung geschlossener Modelle bei anspruchsvollen Reasoning-Tests.
Quelle: Presenc AI, Open Source vs Closed AI Market Share 2026. Werte sind Näherungswerte.
Einzelne Ergebnisse können das Muster brechen. Z.ai's GLM-5.2 erzielte 81,0 auf Terminal-Bench 2.1 gegenüber 83,4 für GPT-5.5; auf SWE-bench Pro erreichte es 62,1 gegenüber 58,6 für GPT-5.5. Mozills eigener Datensatz wies vor GLM-5.2 das beste offene Modell mit 67,9 auf Terminal-Bench 2.1 aus – die Daten des Berichts waren am Erscheinungstag bereits hinter der neuesten Veröffentlichung zurück.
Statistiken zur Entwickler-Adoption und produktiven Nutzung
Mozillas Bericht stützt sich auf eine SlashData-Umfrage unter 1.494 Entwicklern, durchgeführt im Mai 2026, unter Entwicklern, die Anwendungen KI-Funktionen hinzufügen.
Quelle: Mozilla- und SlashData-Entwicklerumfrage 2026, durchgeführt im Mai 2026. Die ersten beiden Zeilen überschneiden sich.
Bei der Produktion trennen sich die beiden Gruppen. Unter Teams mit offenen Modellen erreichen 51 % die Produktion, gegenüber 63 % bei geschlossenen Modellen. Mozillas Berichtsseite nennt den offenen Wert mit 53 %, während der Blogbeitrag 51 % angibt. SlashDatas Alvaro Ruiz Cubero führt die Lücke auf fehlende Infrastruktur und nicht auf die Modellqualität zurück.
Auf die Frage, was Open-Model-Projekte blockiert, nannten die Entwickler am häufigsten die Infrastrukturkosten mit 27 %, gefolgt von Sicherheit und Compliance mit 26 %, Wartung und Updates mit 24 % sowie Deploy-Komplexität mit 23 %. Die vier Antworten liegen nahe beieinander, sodass keine einzelne Maßnahme das Problem löst.
Die Nutzung hängt auch von der Aufgabe ab. Presenc AI schätzt, dass etwa 94 % der Edge- und On-Device-Arbeit ein offenes Modell verwenden, mit Anteilen von etwa 85 % bei kostensensibler Hochvolumen-Arbeit und etwa 71 % bei Arbeit mit sensiblen Daten in Bereichen wie Recht, Finanzen und Gesundheitswesen.
Quelle: Presenc AI, Open Source vs Closed AI Market Share 2026.
Umfrageergebnisse hängen von der Fragestellung ab. Presenc AI zufolge nutzen etwa 89 % der Unternehmen mindestens ein Open-Source-Modell in der Produktion, während die Linux Foundation, zitiert von TechnologyChecker,stellte, dass 63 % der Organisationen Open-Source-KI nutzen und 89 % irgendwo in ihrem KI-Stack Open Source einsetzen.
Die sichtbare Web-Deployment-Basis ist deutlich niedriger. TechnologyChecker durchsuchte im Mai 2026 mehr als 50 Millionen Domains und fand Botpress, das am häufigsten erkennbare Open-Source-KI-Framework, auf 1.558 Domains – gegenüber 52.682 für die geschlossene OpenAI-API und 1.349 für Googles Dialogflow. Von den 899 Unternehmen mit einer Botpress-Bereitstellung hatten 64 % höchstens 10 Beschäftigte, 81 % weniger als 50 und etwa 5 % 1.000 oder mehr. Die Vereinigten Staaten stellten etwa 23 % der erkannten Bereitstellungen, gefolgt von Spanien mit 6,9 % und Indien mit 6 %. TechnologyChecker weist darauf hin, dass seine Methode Backend-Tools wie transformers, LangChain oder Ollama nicht erkennen kann; die Zählungen bilden nur die browserseitige Schicht ab.
Hugging-Face-Ökosystem-Statistiken
Hugging Faces Frühlingsbericht 2026 besagte, dass die Plattform 2025 auf 13 Millionen Nutzer, mehr als 2 Millionen öffentliche Modelle und über 500.000 öffentliche Datensätze wuchs. Der Sommerbericht, der Januar bis August 2026 umfasst, verzeichnete einen Anstieg der öffentlichen Modell-Repositories von 2,43 Millionen auf 2,96 Millionen, der Datensätze von 711.000 auf 1 Million und der Spaces von 1,00 Million auf 1,44 Millionen.
Die Aufmerksamkeit ist stark konzentriert. Der Frühlingsbericht ergab, dass etwa die Hälfte aller Modelle weniger als 200 Downloads insgesamt aufwies und die Top-200-Modelle – 0,01 % der Gesamtmenge – 49,6 % aller Downloads hielten. Der Sommerbericht setzte den Anteil der Modelle mit weniger als 200 Downloads über die gesamte Lebensdauer auf 85,6 % und erklärte, 1,5 % der Repositories seien für 99,2 % der Downloads verantwortlich. Die beiden Berichte zählen unterschiedlich und decken verschiedene Zeiträume ab, zeigen aber beide dasselbe Bild: eine kleine Gruppe von Modellen, die nahezu den gesamten Traffic auf sich zieht.
Der Stanford AI Index 2026 zählt rund 5,6 Millionen KI-bezogene Projekte auf GitHub und Hugging Face, von denen nur 206.880 (3,7 %) 10 oder mehr Sterne haben. Die Modell-Uploads auf Hugging Face verdreifachten sich zwischen 2023 und 2025 und erreichten in einem einzigen Quartal 332.000.
Quelle: Hugging Face, State of Open Source on Hugging Face: Spring 2026, veröffentlicht am 17. März 2026.
Das Mittel ist deutlich schneller gewachsen als der Median. Hugging Face führt den Anstieg am oberen Ende auf Quantisierung und Mixture-of-Experts-Designs zurück, während die Nutzung kleiner Modelle flach bleibt. Kleine Modelle ziehen weiterhin die meisten Downloads an: Modelle 1 Milliarde Parametern stellen 83 % aller Downloads über die gesamte Zeit, Modelle über 100 Milliarden 1 %; bei den Downloads allein im Jahr 2026 gingen 3 % an Modelle über 70 Milliarden Parameter.
Likes und Downloads messen Unterschiedliches. Die Top-25-Repositories nach Downloads 2026 und die Top-25 nach Likes teilten sich genau einen Eintrag. Das Modell all-MiniLM-L6-v2 wurde in sieben Monaten 1,55 Milliarden Mal abgerufen und hat 5.156 Likes.
Qwen ist zur Basis geworden, auf der andere aufbauen. Qwen-basierte Modelle stellen 151.448 Derivate auf dem Hub – das 2,6-fache von Metas Gesamtzahl und das 4,7-fache der Llama-Repositories allein –, gefolgt von Google mit 82.506. Die Qwen-Derivate wuchsen in den ersten sieben Monaten von 2026 um rund 180 bis 210 neue Repositories pro Tag.
Der lokale Betrieb folgt demselben Muster. Qwen verzeichnet 39,6 Millionen GGUF-Downloads pro Monat, gegenüber 20,8 Millionen für Gemma und 7,5 Millionen für Llama. GGUF ist das Dateiformat, das von lokalen Runnern wie llama.cpp verwendet wird.
Das stärkste Wachstum liegt in der Runtime-Schicht. Repositories mit der gguf-Bibliothek stiegen um 464 %, lerobot um 194 % und Apples mlx um 148 %, während transformers und peft um 16 % und diffusers um 21 % wuchsen. Alle Modell-Repositories wuchsen um 21,5 %.
Agenten sind als neue Nutzerklasse hervorgetreten. Claude Code machte im Juli 2026 44,4 % des agent-getaggten Traffics auf dem Hub aus, nach 67,8 % im April, während Codex im selben Zeitraum von 10,4 % auf 20,8 % stieg.
Kosten-, Preis- und Finanzierungsstatistiken
Mozilla berichtet, dass die Inferenzkosten für Modelle der GPT-4-Klasse über 36 Monate von rund 20 $ auf etwa 0,40 $ pro Million Token sanken – ein 50-facher Rückgang, den der Bericht mit dem Wettbewerb durch Open-Weight-Modelle verbindet. Eine im Bericht zitierte Analyse der Linux Foundation setzt die Inferenz geschlossener Modelle auf etwa das Sechsfache der Kosten eines vergleichbaren offenen Modells. Mozilla rechnet diese Lücke in eine Schätzung von 24,8 Milliarden $ an ungenutzten jährlichen Einsparungen um, wenn Käufer geeignete Workloads auf offene Gewichte verlagern würden. Als ein Beispiel senkte Stripe seine Inferenzkosten um 73 %, während es 50 Millionen tägliche API-Aufrufe verarbeitete, indem es einen Teil seiner KI-Arbeit auf offene Modelle verlagerte.
Die Preislisten der Anbieter veranschaulichen die Spanne. Presenc AIs Vergleich vom Mai 2026 listet DeepSeek V4 mit 0,14 $ pro Million Eingabe-Token, gegenüber 3,00 $ für GPT-5.5 und Claude 4.7 Opus.
Quelle: Presenc AI, Open Source vs Closed AI Market Share 2026, Anbieterpreise Mai 2026.
Kleinere geschlossene Modelle liegen nahe an offenen Preisen: GPT-5.5 mini ist mit 0,15 $ und Gemini 3.1 Flash mit 0,075 $ gelistet – in den unteren Preisklassen trennt der Preis allein nicht offen von geschlossen.
Unternehmen auf Basis offener Modelle beginnen, Umsätze auszuweisen. Mozillas Bericht nennt Databricks mit einer Jahreslaufrate von 5,4 Milliarden $ und Mistral AI mit etwa 400 Millionen $ jährlich wiederkehrendem Umsatz, ein 20-facher Anstieg binnen zwölf Monaten. DeepSeek liegt bei etwa 220 Millionen $ und hat 7,4 Milliarden $ bei einer Bewertung von über 50 Milliarden $ aufgenommen. Mistral kündigte am 9. September 2025 eine Series C über 1,7 Milliarden Euro bei einer Post-Money-Bewertung von 11,7 Milliarden an, angeführt von ASML. Zhipu AI und MiniMax verfolgen beide 2026 Börsennotierungen in Hongkong. Im Mai 2026 sagten IBM und Red Hat 5 Milliarden $ für Open-Source-KI-Tooling und -Infrastruktur zu. Market.us prognostiziert, dass der Markt für Open-Source-KI-Modelle von 19,05 Milliarden $ im Jahr 2025 auf 23,08 Milliarden $ im Jahr 2026 wachsen wird, etwa 21 %.
Die Lizenzen zeigen, woher der Ertrag nicht kommt. Von 178 chinesischen Veröffentlichungen über 20 Milliarden Parametern im Jahr 2026 nutzen 59 % Apache 2.0 und 22 % MIT. Bei US-Veröffentlichungen derselben Größenklasse verwenden 29 % Apache oder MIT, 41 % eigene Bedingungen und 30 % machen keine Angabe. Hugging Face weist darauf hin, dass einige der größten recenten Veröffentlichungen, etwa Kimi K3 und Qwen 3.8 2.4T, damit begonnen haben, nicht-kommerzielle Einschränkungen oder Revenue-Share-Bedingungen hinzuzufügen – das Lizenzbild verändert sich.
Quellen
- The ATOM Report (arXiv)
- OpenRouter, State of AI
- Hugging Face, State of Open Source on Hugging Face: Spring 2026
- State of Open Source AI (Mozilla)
- BenchLM, Open Source LLM Statistics (2026)
- Hugging Face, State of Open Models: Summer 2026 Observations
- TechnologyChecker, Open-Source AI Adoption 2026
- Tech Insider, Open-Source AI Powers 33% of Use, Just 4% of Revenue
- Presenc AI, Open Source vs Closed AI Market Share 2026
- Command Linux, Open-Source AI Model Download Statistics 2026
Dieser Artikel erschien ursprünglich auf Blockonomi.

