ChatGPT Images 2.5 vs. Nano Banana 2: Ein Vergleich in sechs Kategorien
Wichtige Erkenntnisse
- •ChatGPT Images 2.5 und Nano Banana 2 gewannen im Vergleich jeweils drei Kategorien.
- •OpenAI zufolge kann das neue Modell die Latenz bei der Bildgenerierung gegenüber Images 2.0 um bis zu 50 % senken.
- •Der Test zeigte, dass ChatGPT Images 2.5 weder den Gelbstich noch die starke Überschärfung früherer Generationen aufwies.
- •Nano Banana 2 gewann den Test mit dichter Beschriftung und die Bitcoin-Zeitleiste, nachdem ChatGPT Images 2.5 Rechtschreib- und Datumsfehler gemacht hatte.
- •OpenAI ergänzte Sketch, das Teilen von Prompts, regionale Kommentare, Formatvorlagen sowie neue API-Qualitätsstufen für „high“ und „max“.
OpenAI brachte ChatGPT Images 2.5 am 8. September auf den Markt und versprach schärfere Details, reichhaltigere Texturen, natürlichere Beleuchtung, präzisere Bearbeitungen sowie eine um bis zu 50 % geringere Latenz bei der Bildgenerierung gegenüber Images 2.0.
In einem Vergleich mit sechs Kategorien gewann Nano Banana 2 drei Tests, während ChatGPT Images 2.5 die anderen drei für sich entschied. Die Ergebnisse wurden weniger durch offensichtliche Qualitätsunterschiede als durch kleine, überprüfbare Fehler bestimmt, darunter ein Rechtschreibfehler und ein falsches Datum in einer auf Recherche basierenden Infografik.
OpenAI zufolge ist die Latenz gegenüber Images 2.0 um bis zu 50 % gesunken. Das Unternehmen hat außerdem zwei API-Modelle hinzugefügt: GPT-Image-2.5 Flare als schnelles Standardmodell und GPT-Image-2.5 Sunburst, das für besonders präzise Bearbeitungen entwickelt wurde.
Der Vergleich folgt auf einen früheren Test, der im Mai veröffentlicht wurde und bei dem GPT Image 2 und Nano Banana 2 in acht Kategorien abwechselnd gewannen. GPT Image 2 entschied mehr Kategorien für sich, entwickelte jedoch einen charakteristischen Überschärfungsfehler, wenn Prompts zahlreiche gleichzeitige Vorgaben enthielten. Daraus ergab sich eine Frage für das nächste Modell: Würde OpenAI dieses Problem beheben?
Für diese Runde verwendete derselbe Tester sechs Kategorien, die aus den früheren Tests übernommen oder angepasst wurden, und gab beiden Modellen dieselben Prompts. Bei Googles Modell handelte es sich um Nano Banana 2, die Bezeichnung des Unternehmens für Gemini 3.1 Flash Image, und nicht um das langsamere und bedächtigere Nano Banana Pro. Der Test verglich daher OpenAIs neues, schnelles und präzisionsorientiertes Modell mit Googles entsprechendem Angebot.
Was sich bei GPT-Image-2.5 geändert hat
Die Bildmodelle von OpenAI waren in der Vergangenheit mit charakteristischen Fehlern verbunden. Das Modell hinter dem ursprünglichen GPT Image 1 entwickelte einen anhaltenden warmen Gelbstich, den Nutzer als „piss filter“ bezeichneten. OpenAI erklärte oder behob diesen Farbstich nie vollständig.
GPT Image 2 ersetzte dieses Problem durch ein anderes: Prompts mit zu vielen aufeinanderfolgenden Vorgaben konnten stark überschärfte Bilder mit zahlreichen krisseligen, überbearbeiteten Artefakten erzeugen.
Keines der beiden Probleme trat in diesem Test auf. Die mit ChatGPT Images 2.5 erzeugten Bilder bewahrten ihre Farbbalance und Detailtreue auch bei voller Prompt-Komplexität. Der Gelbstich und die übermäßige Schärfung der beiden früheren Generationen waren nicht vorhanden. Besonders deutlich zeigte sich die Verbesserung bei den Steampunk- und Porträttests, die über die drei getesteten Generationen hinweg die fotografisch stimmigsten ChatGPT-Bilder hervorbrachten.
OpenAI hat außerdem Workflow-Funktionen eingeführt, die ein einfacher Bild-zu-Bild-Vergleich nicht erfasst. Mit Sketch können Nutzer direkt in ChatGPT ein grobes Layout als Referenz für die Generierung zeichnen. Weitere Ergänzungen sind das Teilen von Prompts, Inline-Kommentare zu bestimmten Bildbereichen sowie Formatvorlagen für Poster und Merchandise. In der API reichen die Qualitätsstufen nun von „low“ über die neuen Einstellungen „high“ und „max“ hinaus über das Niveau, bei dem Images 2.0 endete.
So schnitten die beiden Modelle in den sechs Kategorien ab.
Beschriftungsdichte: die Szene von Kellerman’s Hardware
Der erste Test zeigte eine düstere Kreuzung um 2 Uhr morgens, auf der fast jede Oberfläche lesbaren Text enthielt: ein verblasstes altes Schild, aufgesprühte Graffiti, Beschriftungen an einem Laden, ein zerrissenes Konzertplakat, einen schablonierten Bordstein und ein mit Aufklebern bedecktes Münztelefon.
Nano Banana 2 stellte fast den gesamten Text sauber dar. Der wichtigste Fehler war ein Aufkleber am Münztelefon, der seinen eigenen Text in verstümmelter Form wiederholte – ein kleiner Fehler, der leicht übersehen werden konnte.
ChatGPT Images 2.5 enthielt ein Detail, das Nano Banana 2 ausließ: einen Laternenpfahl mit überlappenden, festgetackerten Flugblättern, die wie im Prompt beschrieben zerrissen und verwittert waren. Das Street-Art-Tag des Modells schien jedoch „STILLL HERE“ mit einem zusätzlichen L zu lauten. Auch der Apostroph in „KELLERMAN’S“ auf dem alten Schild fehlte oder war nicht lesbar.
Obwohl OpenAI insgesamt die realistischere Szene erzeugte, unterliefen dem Modell in einem Test zur präzisen Textdarstellung zwei separate Lesbarkeitsfehler. Nano Banana 2 gewann die Kategorie.
Sieger: Nano Banana 2
Räumliches Bewusstsein: der Steampunk-Uhrturm
Dieser Test zur Luftbildkomposition erforderte eine Szene mit fünf Tiefenebenen und einem massiven Uhrturm. Seine Zifferblätter sollten mithilfe lesbarer römischer Ziffern unterschiedliche Zeiten anzeigen, während sechs zusätzliche Textelemente vom Vordergrund bis zum Hintergrund verteilt waren.
ChatGPT Images 2.5 erzeugte mit deutlichem Abstand das atmosphärischere Bild. Sichtbarer Dampf stieg von den Dächern auf, ein Fluss verlief durch die mittlere Bildebene und die Tonwertspanne war über die fünf Tiefenebenen hinweg größer. Auch der Text war leichter zu lesen.
Nano Banana 2 erzeugte eine flachere Atmosphäre. Auf den beiden sichtbaren Zifferblättern waren zwar lesbare römische Ziffern zu sehen – XII, III, VI und IX –, doch die Zeiger standen auf beiden Uhren ähnlich, entgegen der Aufforderung im Prompt, unterschiedliche Zeiten darzustellen.
ChatGPT Images 2.5 gewann, weil es die Anweisungen genauer befolgte, ohne an Realismus einzubüßen.
Sieger: ChatGPT Images 2.5
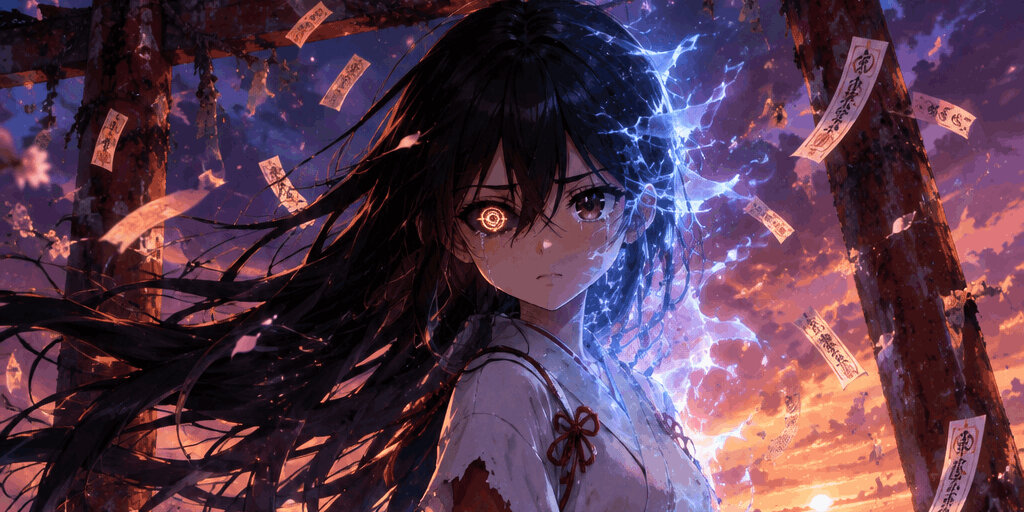
Illustration: das Anime-Spiritmedium
Der Prompt verlangte ein Key Visual im Stil von Studio Ufotable, das ein Mädchen bei der Verwandlung in spirituelle Energie an einem Torii-Tor zeigt, begleitet von einem neunschwänzigen Kitsune-Fuchs unter einem im Stil von Makoto Shinkai gemalten Dämmerungshimmel.
ChatGPT Images 2.5 erzeugte den stärksten Himmel der gesamten Testreihe. Das Bild enthielt eine sichtbare Sonnenscheibe, eine Spiegelung im Wasser und eine Bergsilhouette, die den Vergleich mit Shinkai stützte. Auch die asymmetrischen Augen der Figur funktionierten gut.
Weniger wörtlich setzte das Modell die Anweisung um, dass sich das Mädchen „in Energie auflösen“ sollte. Es interpretierte diese Idee als elektrisches Knistereffekt-Muster in ihrem Haar und nicht als die im Prompt beschriebene fließende, durchscheinende Auflösung. Die zarte blau-weiße Energiespur von Nano Banana 2 entsprach dieser konkreten Anweisung besser.
Keines der beiden Modelle erzeugte einen überzeugenden neunschwänzigen Fuchs. ChatGPT Images 2.5 gewann dennoch aufgrund der insgesamt stärkeren visuellen Wirkung.
Sieger: ChatGPT Images 2.5
Realismus: die Architektin auf dem Dach
Dieses filmische Porträt enthielt zahlreiche unabhängige Vorgaben: einen beigefarbenen Trenchcoat, eine runde Brille, Baupläne ausdrücklich in der linken Hand, Licht der goldenen Stunde, geringe Tiefenschärfe und Filmkorn.
ChatGPT Images 2.5 erzeugte eindrucksvolles Licht. Die Sonnenscheibe war direkt hinter der Person sichtbar, und die mikroskopischen Hautdetails waren ausgezeichnet. Die Haut war zu glatt, doch die Umgebung wirkte äußerst realistisch und erinnerte an eine Aufnahme mit einer Analogkamera.
Das Hinzufügen von Anweisungen, die normalerweise die fotografische Qualität verringern würden, steigerte unerwartet den Realismus des Bildes. Bei einer Generierung wurden unter anderem die Schlüsselwörter „realistic, highlights, crushed shadows, uneven flash, blown out skin tones, candid moment, shot on a phone camera“ verwendet.
Nano Banana 2 bewahrte eine vollständigere Komposition und platzierte die Baupläne in der rechten statt in der geforderten linken Hand. Das Modell fügte jedoch eine lesbare Beschriftung auf dem Bauplan hinzu: „PROJECT: 124 DUANE ST“, ein Detail, das bei den meisten Generierungen fehlte.
Nano Banana 2 gewann den Vergleich einer einzelnen Aufnahme, während ChatGPT Images 2.5 bei wiederholten Durchläufen als stärker beurteilt wurde.
Sieger: Nano Banana 2 bei einer Aufnahme; ChatGPT Images 2.5 bei wiederholten Durchläufen
Agentische Recherche: die Bitcoin-Zeitleiste
Beide Plattformen können ein Thema recherchieren, bevor sie ein Bild erzeugen. Der Test verlangte eine Breitbild-Zeitleiste zur Geschichte von Bitcoin im Stil einer Kinderzeichnung mit einer strengen Vorgabe zur faktischen Genauigkeit. Es war die wichtigste Kategorie des Vergleichs und zeigte den größten Abstand zwischen den Modellen.
ChatGPT Images 2.5 erzeugte eine übersichtliche Infografik mit zwei Zeilen und zahlreichen konkreten Daten, doch eines davon war falsch. Das Modell nannte 2023 als Jahr der Zulassung von Bitcoin-ETFs in den USA. Die U.S. Securities and Exchange Commission genehmigte die ersten Spot-Bitcoin-ETFs tatsächlich am 10. Januar 2024, also ein volles Jahr später. Der Ausgangstext merkte an, dass die Abweichung auf ein Interpretationsproblem zurückgehen könnte, da Futures-ETFs in jenem Jahr genehmigt worden waren.
Nano Banana 2 erzeugte eine weniger strukturierte Zeitleiste mit ähnlichen Ereignissen. Das Modell verwendete für die ETF-Zulassung und das vierte Halving den Zeitraum „2023–2024“, statt ein einzelnes falsches Jahr zu behaupten. Daher war keines der genannten Daten technisch falsch.
Nano Banana 2 gewann, weil ein selbstbewusst präsentierter falscher Termin in einem Test zur Genauigkeit agentischer Recherche stärker ins Gewicht fällt.
Sieger: Nano Banana 2
Abstrakte Konzepte: ein Prompt aus erfundenen Wörtern
Der letzte Prompt bestand fast vollständig aus erfundenen Begriffen: „A woman eating shmfiyxl in Lyxin. Next to her, her Lymglsushing plays Lakishkark.“ Für das Gericht, den Ort, die Begleitperson und die Aktivität gab es keine Wörterbuchdefinitionen. Jedes Modell musste daher deren Bedeutung erfinden und entscheiden, wie es sie darstellen wollte.
ChatGPT Images 2.5 integrierte die unsinnigen Wörter direkt als sichtbaren Text in die Szene. „Lyxin“ erschien auf einem Neonschild über einem eleganten, futuristischen Restaurant, während „Lakishkark“ auf dem Karton eines Brettspiels stand, das die außerirdische Tischpartnerin der Frau spielte. Indem das Modell die erfundenen Begriffe in lesbare Beschriftungen verwandelte, machte es sie konkret statt abstrakt.
Nano Banana 2 wählte einen anderen Ansatz. Das Modell erzeugte eine warme, kulturell spezifische Szene mit einem guatemaltekischen Marktstand, einer Frau in einem traditionellen Huipil und einer orkähnlichen Kreatur, die ein hybrides Saiten- und Blasinstrument spielte. Es interpretierte „plays“ als Musizieren und nicht als Spielen eines Spiels – eine andere, aber ebenfalls gültige Lesart des Prompts.
Allerdings verwies nichts im Bild konkret auf „Lyxin“ oder „Lakishkark“, und keines der erfundenen Wörter erschien als sichtbarer Text. ChatGPT Images 2.5 gewann, weil die Umwandlung undefinierter Konzepte in lesbare Beschriftungen die wörtlichere Antwort auf einen Prompt war, der keine etablierten Bedeutungen vorgab.
Sieger: ChatGPT Images 2.5
Das Fazit
Nano Banana 2 gewann drei der sechs Kategorien, womit der Vergleich effektiv unentschieden ausging. Das Ergebnis hängt von den Erwartungen der Nutzer und der Art der Verwendung des Modells ab.
ChatGPT Images 2.5 behob das Überschärfungsproblem seines Vorgängers. Die Illustration des Modells war möglicherweise das visuell eindrucksvollste Einzelbild, das eines der beiden Modelle in den beiden vollständigen Testrunden erzeugte.
Die Wahl des Modells hängt daher von der Aufgabe ab: Bei textlastigen und recherchebasierten Bildern kommt es stärker auf exakte Lesbarkeit und Faktenprüfung an, während Illustrationen und Workflows mit wiederholten Generierungen andere in diesem Test gezeigte Stärken betonen. Der Vergleich bestimmt keinen universellen Sieger, zeigt aber, warum die Bewertung von Bildmodellen mehr erfordert, als ein einzelnes Bild nur nach seiner visuellen Wirkung zu beurteilen.
Der wichtigste Unterschied lag nicht in der Gesamtqualität, sondern in einer Reihe kleiner, überprüfbarer Details: einem Rechtschreibfehler in einer Szene mit dichter Beschriftung, einem falschen Jahr in einer recherchebasierten Infografik und weiteren begrenzten Fehlern bei der Befolgung von Anweisungen. Bei der Gesamtästhetik und Bildqualität waren die beiden Modelle weitgehend vergleichbar.

