KI-Modellkosten: Trainingsausgaben steigen, während Inferenzpreise einbrechen
Wichtige Erkenntnisse
- •Epoch AI schätzt, dass die amortisierten Hardware- und Energiekosten von Frontier-Trainingsläufen seit 2016 um etwa das 2,4-Fache pro Jahr gestiegen sind, und prognostiziert, dass die größten Läufe rund 2027 die Marke von 1 Milliarde US-Dollar überschreiten könnten, wenn der Trend anhält.
- •Die geschätzte Trainingsrechenleistung erreichte etwa 79 Millionen US-Dollar für GPT-4, 192 Millionen US-Dollar für Gemini 1.0 Ultra und 170 Millionen US-Dollar für Llama 3.1 405B, während Hardware 47 % bis 67 % der Frontier-Entwicklungskosten ausmacht und Forschungspersonal weitere 29 % bis 49 %.
- •DeepSeek meldete etwa 5,576 Millionen US-Dollar an Trainingsrechenleistung für DeepSeek-V3, basierend auf rund 2,788 Millionen Nvidia-H800-GPU-Stunden – eine Zahl, die frühere Forschung, Ablationsstudien und andere Entwicklungskosten ausschließt.
- •Die Kosten für das Erreichen eines festen KI-Leistungsniveaus sind seit 2023 um etwa 47 % pro Quartal gesunken, etwa das 13-Fache pro Jahr – ein Tempo, das laut Epoch AI schneller ist als frühere Kostenkurven wie DNA-Sequenzierung und Lithium-Ionen-Batterien.
- •Inferenz auf GPT-3.5-Niveau fiel von etwa 20 US-Dollar pro einer Million Tokens Ende 2022 auf 0,07 US-Dollar bis Oktober 2024, und bis Oktober 2026 verlangten kleine kommerzielle Modelle wie GPT-6 Luna und Claude Haiku 5.5 nur 0,10 US-Dollar pro einer Million Input-Tokens und 0,50 US-Dollar pro einer Million Output-Tokens.
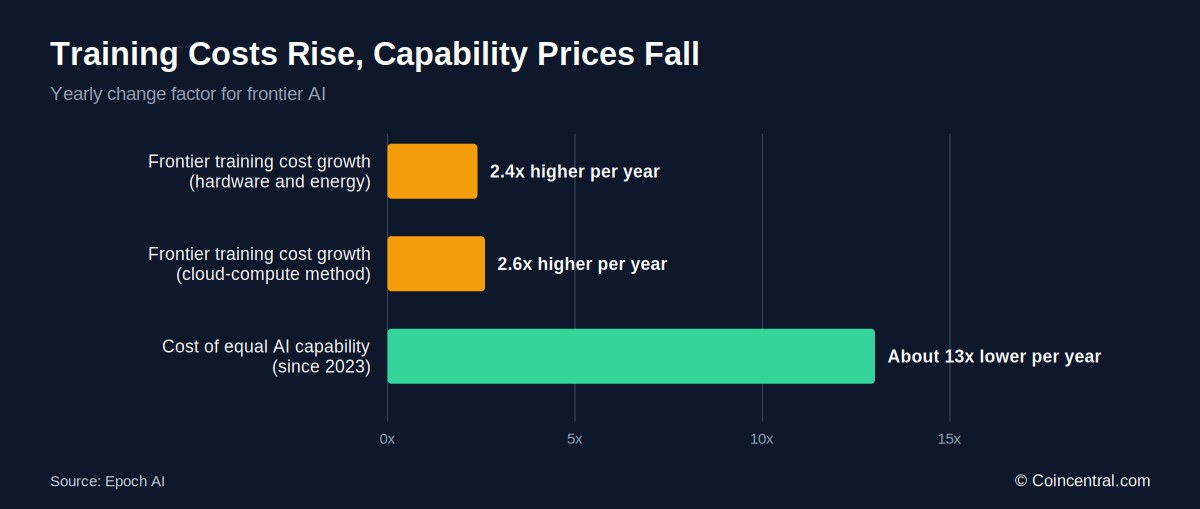
Künstliche Intelligenz ist in eine Ära gespaltener Ökonomie eingetreten: Die Kosten für den Bau von Frontier-Modellen steigen weiter, während die Kosten für ihre Nutzung weiter sinken. Beide Trends schreiten gleichzeitig voran.
Das Training eines Frontier-KI-Modells kann Rechenleistung im Wert von Zehn- oder sogar Hunderten von Millionen US-Dollar erfordern. Epoch AI schätzt, dass die Hardware- und Energiekosten dieser Trainingsläufe um roughly das 2,4-Fache pro Jahr gewachsen sind.
Sobald ein Modell trainiert ist, kehrt sich das Bild um. Nach Angaben von Epoch AI ist der Preis für das Erreichen eines festen KI-Leistungsniveaus seit 2023 um etwa 47 % pro Quartal gesunken – was ungefähr einem 13-fachen Rückgang pro Jahr entspricht.
Dieser Artikel fasst die wichtigsten Zahlen zu Trainingskosten, Inferenzkosten und Token-Preisen zusammen und stützt sich dabei auf Daten von Epoch AI, der Stanford University, DeepSeek, OpenAI, Anthropic und Google. Alle Preise sind die standardmäßig veröffentlichten Tarife Stand Oktober 2026.
KI-Modellkosten auf einen Blick
- Die Trainingskosten für Frontier-KI-Modelle sind um etwa das 2,4-Fache pro Jahr gestiegen.
- Epoch AI prognostiziert, dass die größten Trainingsläufe rund 2027 die Marke von 1 Milliarde US-Dollar überschreiten könnten, wenn der Trend anhält.
- Die Trainingsrechenleistung von GPT-4 wird auf etwa 79 Millionen US-Dollar geschätzt.
- Gemini 1.0 Ultra wird auf etwa 192 Millionen US-Dollar geschätzt.
- Llama 3.1 405B wird auf etwa 170 Millionen US-Dollar geschätzt.
- Grok-2 wird auf etwa 107 Millionen US-Dollar geschätzt.
- DeepSeek meldete 5,576 Millionen US-Dollar für den offiziellen DeepSeek-V3-Trainingslauf, eine Zahl, die frühere Forschungs- und Personalkosten ausschließt.
- Hardware macht etwa 47 % bis 67 % der Entwicklungskosten von Frontier-Modellen aus; Forschungs- und Entwicklungspersonal macht weitere 29 % bis 49 % aus.
- Energie macht nur etwa 2 % bis 6 % aus.
- Die Kosten für gleiche KI-Leistung sinken um etwa 47 % pro Quartal, also etwa das 13-Fache pro Jahr.
- Inferenz auf GPT-3.5-Niveau sank zwischen Ende 2022 und Ende 2024 um mehr als das 280-Fache.
- GPT-6 Luna und Claude Haiku 5.5 kosten 0,10 US-Dollar pro einer Million Input-Tokens und 0,50 US-Dollar pro einer Million Output-Tokens.
- Gecachte Tokens können auf einigen APIs 90 % bis 95 % günstiger sein als normale Input-Tokens.
Die wachsende Kluft zwischen steigenden Trainingskosten und sinkenden Nutzungskosten steht im Zentrum der KI-Ökonomie. Der Rest dieses Artikels beleuchtet beide Seiten der Reihe nach.
Wie viel kostet das Training eines KI-Modells?
Darauf gibt es keine einzelne Antwort. Die Kosten reichen von wenigen Hundert US-Dollar für frühe Forschungsmodelle bis zu Hunderten von Millionen US-Dollar für Frontier-Systeme.
Stanfords AI Index, der auf gemeinsam mit Epoch AI entwickelten Schätzungen basiert, verfolgt, wie sich die Trainingskosten entwickelt haben. Stanford weist darauf hin, dass diese Zahlen meist die verbrauchten Rechenressourcen schätzen und nicht die vollen wirtschaftlichen Kosten des Modellbaus. Dennoch ist der Wandel über sieben Jahre dramatisch: Das originale Transformer-Modell kostete geschätzte weniger als 1.000 US-Dollar an Rechenleistung, während GPT-4 etwa 79 Millionen US-Dollar kostete – mehr als das 100.000-Fache.
Nicht jedes Modell folgt der Aufwärtskurve. Llama 2 70B kostete mit etwa 3 Millionen US-Dollar weniger als GPT-3 mit 4 Millionen und weit weniger als PaLM 540B mit 12 Millionen US-Dollar. Modellgröße, Chiptyp und Trainingsmethode beeinflussen alle die Endrechnung.
Frontier-Trainingskosten wachsen 2 bis 3 Mal pro Jahr
Epoch AI untersuchte Dutzende großer KI-Systeme und schätzt, dass die amortisierten Hardware- und Energiekosten von Frontier-Trainingsläufen seit 2016 um etwa das 2,4-Fache pro Jahr gestiegen sind. Eine separate Methode auf Basis von Cloud-Compute-Preisen fand eine ähnliche Rate von 2,6 Mal pro Jahr. Dass zwei unabhängige Ansätze auf denselben Bereich verweisen, verleiht der Schätzung zusätzliches Gewicht.
Wenn der Trend anhält, prognostiziert Epoch, dass die größten Frontier-Modelle rund 2027 die Marke von 1 Milliarde US-Dollar pro Trainingslauf überschreiten könnten. Stanford stellte 2026 fest, dass Branchenschätzungen für neue Frontier-Systeme inzwischen zwischen Hunderten von Millionen US-Dollar und Richtung 1 Milliarde US-Dollar pro Iteration liegen.
Das bedeutet nicht, dass jedes künftige Spitzenmodell eine Milliarde US-Dollar kosten wird. Mixture-of-Experts-Architekturen, bessere Daten, verbesserte Algorithmen und günstigere Hardware können die Rechenleistung für ein bestimmtes Leistungsniveau alle verringern. DeepSeek hat gezeigt, wie groß dieser Unterschied sein kann.
Trainingskosten von DeepSeek-V3
DeepSeek erregte große Aufmerksamkeit, nachdem es Trainingsrechenkosten von etwa 5,576 Millionen US-Dollar für DeepSeek-V3 meldete. Sein technischer Bericht gibt an, dass der gesamte offizielle Trainingsprozess rund 2,788 Millionen Nvidia-H800-GPU-Stunden nutzte. Bei einem angenommenen Mietpreis von 2 US-Dollar pro GPU-Stunde ergibt sich daraus die Zahl von 5,576 Millionen US-Dollar.
Die Zahl wird häufig missverstanden. Sie ist nicht die Gesamtkosten der Entwicklung von V3. DeepSeek erklärte, dass die Zahl frühere Forschung, Architektur-Experimente, Ablationsstudien, Datenarbeit und andere Entwicklungskosten ausschließt. Aus diesem Grund kann sie nicht direkt mit Schätzungen verglichen werden, die breitere F&E-Ausgaben einbeziehen; ein fairer Vergleich erfordert auf beiden Seiten denselben Umfang.
Was die Zahl zeigt, ist, dass Design- und Engineering-Entscheidungen die Kosten eines abschließenden großen Trainingslaufs drastisch senken können – eine Erkenntnis mit Bedeutung für die gesamte Branche.
Rechenleistung ist nur ein Teil der Kosten
Der Bau eines Frontier-Modells erfordert mehr als GPUs. Epoch AI schätzt, dass sich die Gesamtentwicklungskosten auf drei Hauptbereiche verteilen: Hardware macht etwa 47 % bis 67 % aus, Forschungs- und Entwicklungspersonal weitere 29 % bis 49 %, und Energie nur etwa 2 % bis 6 %.
Weitere Kosten können Datenbeschaffung, Datenbereinigung, gescheiterte Experimente, Post-Training und Reinforcement Learning umfassen. Sicherheitstests, Modellevaluationen, Netzwerktechnik, Speicher und Rechenzentrumsanlagen kommen hinzu.
Dadurch kann die offiziell genannte Kostenzahl eines abschließenden Trainingslaufs erheblich unterschlagen, was es kostet, ein wettbewerbsfähiges Frontier-Modell zu bauen – die Lücke zwischen beiden Zahlen kann groß sein.
Inferenz und Token-Preise
Training vs. Inferenz
Training erzeugt ein Modell; Inferenz betreibt es. Unternehmen zahlen für Inferenz jedes Mal, wenn jemand das Modell nutzt. Wenn Millionen von Menschen ein Modell täglich verwenden, können die gesamten Inferenzausgaben die Kosten des ursprünglichen Trainingslaufs übersteigen.
Diese Dynamik gewinnt an Bedeutung, da KI in Coding-Agents, KI-Suche, Kundenservice, Sprachassistenten, Videoanalyse und Geschäftsautomatisierung Einzug hält. Eine Chatbot-Antwort von einigen Hundert Tokens ist günstig; ein Coding-Agent, der Millionen von Tokens liest, wiederholt Tools aufruft und stundenlang läuft, verbraucht weit mehr Rechenleistung.
Aktuelle Token-Preise
Die meisten kommerziellen KI-APIs rechnen pro Token ab. Ein Token ist ein kleines Textstück, und eine Million Tokens entspricht Hunderttausenden englischer Wörter, wobei das genaue Verhältnis variiert.
Die Preise von 2 und 10 US-Dollar für Gemini 4 Argon sind Einführungspreise bis zum 30. November 2026. Google gibt an, dass die Standardpreise danach auf 4 US-Dollar für Input und 20 US-Dollar für Output steigen.
Dies sind Listenpreise. Sie sind nicht die eigenen Kosten der Anbieter für den Betrieb der Modelle.
Kleine Modelle vs. Frontier-Modelle
OpenAIs GPT-6 Luna berechnet 0,10 US-Dollar pro einer Million Input-Tokens und 0,50 US-Dollar pro einer Million Output-Tokens. Anthropics Claude Haiku 5.5 führt denselben Tarif für Prompts unter 100.000 Tokens. Anthropic veröffentlichte Haiku 5.5 im Oktober 2026 und gibt an, dass das Modell im Durchschnitt etwa 75 % günstiger zu betreiben ist als Haiku 4.5.
Zu diesen Tarifen zahlt ein Unternehmen, das 100 Millionen Input-Tokens an ein 0,10-US-Dollar-Modell sendet, nur 10 US-Dollar, während 10 Millionen Output-Tokens zu je 0,50 US-Dollar pro Million weitere 5 US-Dollar kosten. Output ist teurer, weil Modelle Tokens einzeln erzeugen, was mehr Rechenleistung erfordert.
Günstige Modelle eignen sich nicht für jede Aufgabe. Frontier-Reasoning-Systeme benötigen weit mehr Rechenleistung, und die Anbieter berechnen entsprechend mehr: Anthropic listet Claude Opus 5.5 mit 4 US-Dollar pro einer Million Input-Tokens und 20 US-Dollar pro einer Million Output-Tokens – das 40-Fache des Output-Preises von Haiku 5.5.
Diese Spanne gibt KI-Agents einen klaren Anreiz, einfache Aufgaben an kleine Modelle zu delegieren und die teuren Modelle für anspruchsvolles Reasoning aufzusparen.
KI-Inferenzkosten sind stark gefallen
Stanfords AI Index liefert ein deutliches Beispiel. Im November 2022 kostete GPT-3.5-Niveau-Leistung auf dem MMLU-Benchmark etwa 20 US-Dollar pro einer Million Tokens. Bis Oktober 2024 erreichte Gemini 1.5 Flash-8B dasselbe Benchmark-Niveau für 0,07 US-Dollar pro einer Million Tokens – ein Rückgang von mehr als dem 280-Fachen in unter zwei Jahren.
Stanford stellte fest, dass Inferenzpreise je nach gemessener Aufgabe zwischen dem 9-Fachen und dem 900-Fachen pro Jahr fielen. Die Spanne ist breit, weil jeder Benchmark und jedes Leistungsniveau seine eigene Preisgeschichte hat.
Geringere Gewinnmargen sind nicht die einzige Ursache. KI-Modelle und die Hardware, auf der sie laufen, sind weit effizienter geworden.
Der Preis für gleiche KI-Fähigkeit fällt 13 Mal pro Jahr
Epoch AIs Forschung vom September 2026 geht über reine Token-Preise hinaus und misst, was es kostet, ein festes Modellleistungsniveau zu erreichen. Epoch schätzt, dass diese Kosten seit 2023 um etwa 47 % pro Quartal gefallen sind. Über ein ganzes Jahr summiert sich das auf einen Rückgang von etwa dem 13-Fachen.
Die Rechnung ist einfach. Sinken die Preise pro Quartal um 47 %, bleiben 53 %. Nach vier Quartalen bleiben etwa 7,9 % – nahezu ein Dreizehntel.
Epoch sagt, dieser Rückgang sei schneller als frühere große technologische Kostenkurven, darunter DNA-Sequenzierung, Allzwech-Computing, Lithium-Ionen-Batterien und Stromkosten. Die Rate variiert je nach Aufgabe.
Hardware und Software machen KI günstiger im Betrieb
KI-Inferenz profitiert von stetigen Fortschritten bei der Chip-Ökonomie, die Stanford über drei jährliche Trends für Machine-Learning-Hardware verfolgt. Moderne GPUs verwenden zudem Zahlformate mit geringerer Präzision, bessere Speichersysteme und schnellere Verbindungen zwischen Chips. Jede Änderung lässt ein Rechenzentrum mehr Arbeit für dasselbe Geld leisten.
Software verstärkt die Gewinne. Techniken wie Quantisierung, Destillation, Sparsity, Mixture-of-Experts-Architekturen, Speculative Decoding, Continuous Batching und bessere Compiler reduzieren alle die pro Antwort benötigte Rechenleistung. Dadurch kann dieselbe Menge an KI-Fähigkeit im Zeitverlauf mit weniger Rechenressourcen bereitgestellt werden.
Caching und Batch-Verarbeitung senken die Kosten weiter
Moderne APIs gewähren zunehmend Rabatte auf wiederholte Informationen. Stellen Sie sich einen KI-Agenten vor, der bei jeder Anfrage dasselbe 100-seitige Unternehmenshandbuch mitsendet: Ein Anbieter kann diesen Text cachen, statt ihn jedes Mal neu zu verarbeiten.
OpenAI berechnet für GPT-6 Sol 0,20 US-Dollar pro einer Million gecachter Input-Tokens, gegenüber 2 US-Dollar für normalen Input – ein Rabatt von 90 %. Googles Gemini 4 Argon gewährt derzeit 95 % Rabatt auf qualifizierten implizit gecachten Input.
Nutzer, die keine sofortigen Antworten benötigen, können ebenfalls weniger zahlen. OpenAI preist die Batch- und Flex-Verarbeitung für GPT-6 Sol bei etwa 50 % der Standardtarife. Batch-Verarbeitung eignet sich für Dokumentenklassifizierung, Analyse über Nacht, Datenextraktion, groß angelegte Zusammenfassungen und Offline-Evaluationen.
KI-Preisgestaltung beginnt, Cloud-Computing zu ähneln: Kunden zahlen unterschiedliche Tarife je nach Geschwindigkeit, Zuverlässigkeit und Flexibilität der Workload.
Kosten pro Aufgabe und Gesamtausgaben für KI
Warum der Preis pro Token irreführen kann
Ein Modell, das 1 US-Dollar pro einer Million Tokens kostet, ist nicht immer günstiger als eines, das 2 US-Dollar kostet. Angenommen, das erste Modell benötigt 5 Millionen Tokens für eine Aufgabe, während das zweite mit 1 Million auskommt. Das erste Modell kostet 5 US-Dollar für die Aufgabe, das zweite 2 US-Dollar.
Reasoning-Modelle machen diese Prüfung wichtiger, weil sie große Mengen interner Denktokens erzeugen können – und einige davon werden abgerechnet. Anthropic sagt, dass Claude Sonnet 5.5 pro Aufgabe weniger Tokens verwendet als Sonnet 5, was es in realen Workflows günstiger machen kann, selbst wo die Listenpreise ähnlich aussehen. Unternehmen verfolgen zunehmend die Kosten pro erfolgreich abgeschlossener Aufgabe statt nur der Kosten pro einer Million Tokens.
Was die Preise weiter fallen lässt
Drei Kräfte drücken die Inferenzkosten nach unten: effizientere Hardware, effizientere Modellarchitekturen und starker Wettbewerb zwischen den Anbietern.
OpenAI senkte die API-Preise für GPT-6 Sol und Luna um etwa 50 % gegenüber ihren GPT-5.6-Promotion-Pendants und verbesserte zugleich die Fähigkeiten. Anthropic sagt, dass Haiku 5.5 pro typischer Workload etwa 75 % weniger kostet als Haiku 4.5. Google konkurriert ebenfalls bei den Token-Preisen.
Das Ergebnis: KI-Anwendungen, die vor zwei oder drei Jahren zu teuer waren, passen inzwischen in gewöhnliche Produkte.
Fallende Kosten können die Gesamtausgaben erhöhen
Günstigere KI bedeutet nicht immer geringere Branchenausgaben. Ein Unternehmen würde eine Million Kundenchats vielleicht nicht automatisieren, wenn jeder 1 US-Dollar kostet. Bei einem Cent pro Chat automatisiert es vielleicht alle.
Das Muster ähnelt dem Jevons-Paradoxon, bei dem effizientere Nutzung einer Ressource zu mehr Gesamtnutzung führt. Es könnte erklären, warum die größten Cloud-Unternehmen weiterhin Hunderte Milliarden US-Dollar in KI-Rechenzentren investieren, während die Kosten pro Abfrage sinken.
Fazit
Die KI-Ökonomie bewegt sich gleichzeitig in zwei Richtungen. An der Frontier sind die Trainingskosten schnell gestiegen: GPT-4 benötigte geschätzte 79 Millionen US-Dollar an Trainingsrechenleistung, Gemini 1.0 Ultra etwa 192 Millionen und Llama 3.1 405B etwa 170 Millionen, wobei Epoch AI schätzt, dass die Frontier-Trainingskosten um etwa das 2,4-Fache pro Jahr gewachsen sind.
Sobald Modelle verfügbar sind, fallen die Nutzungskosten schnell. Inferenz auf GPT-3.5-Niveau sank von etwa 20 US-Dollar pro einer Million Tokens 2022 auf 0,07 US-Dollar 2024, und neuere Epoch-Forschung setzt den Rückgang der Kosten für ein festes KI-Leistungsniveau bei etwa 47 % pro Quartal, also etwa das 13-Fache pro Jahr. Bis Oktober 2026 kosteten kleine kommerzielle Modelle nur 0,10 US-Dollar pro einer Million Input-Tokens und 0,50 US-Dollar pro einer Million Output-Tokens.
Kurz gesagt: Die modernsten Modelle kosten mehr im Aufbau, während ihr Output günstiger in der Nutzung ist. Wenn das so weitergeht, hängt die Wirkung von KI künftig weniger davon ab, was ein Modell im Training kostet, und mehr davon, was passiert, wenn Milliarden von Menschen und Unternehmen leistungsfähige KI zu Preisen nahe gewöhnlicher Cloud-Software erreichen können.
Quellen
- Epoch AI: The Plunging Price of Thought
- Epoch AI: How Much Does It Cost to Train Frontier AI Models?
- Stanford University: 2025 AI Index Report, Research and Development
- Stanford University: 2026 AI Index Report
- DeepSeek: DeepSeek-V3 Technical Report
- OpenAI: Introducing GPT-6 Sol and Luna
- OpenAI: API Pricing
- Anthropic: Claude Haiku 5.5
- Anthropic: Claude Sonnet 5.5
- Google AI: Gemini 4 Argon Pricing
Dieser Artikel erschien ursprünglich auf CoinCentral.

